摘要. 2023 年开源大语言模型(LLM)的上下文窗口普遍为 4K–8K tokens,2024 年进入 128K,到 2025–2026 年,DeepSeek-V4、MiniMax-M3、Kimi Linear、Qwen3.5 等模型已经把原生或可用上下文推到 1M tokens 量级。推动这一变化的主要是 agentic 工作负载:长工具调用轨迹、仓库级代码理解、多轮强化学习 rollout 都需要模型在数十万到上百万 token 上进行推理。标准 softmax attention 在这个尺度上有三个根本问题:预填充计算随 \(N^2\) 增长,解码时的 KV cache 显存与带宽随 \(N\) 线性增长,以及训练长度之外的位置泛化和注意力稀释。本文用一套统一的数学符号,从原始 attention 出发推导这些问题,再按“问题 → 解法”梳理开源模型采用的八个技术方向:(A) IO 感知的精确注意力;(B) 位置编码与长度外推;(C) 沿宽度压缩 KV(MQA/GQA/MLA);(D) 静态稀疏与局部-全局交错(SWA、attention sink、chunked attention);(E) 内容相关的动态稀疏(MoBA、NSA、DSA、MSA);(F) 沿序列长度压缩 KV(NSA 压缩分支、DeepSeek-V4 的 CSA/HCA);(G) 线性注意力与状态空间记忆(Linear Attention → Mamba-2/GLA → DeltaNet → Gated DeltaNet → KDA);(H) 层间混合架构。我们提出一个“记忆写入—读取”统一框架,把所有方法写成同一个公式的不同特例,并给出复杂度、KV cache、代表模型与训练配方的横向比较。
目录
- 引言
- 统一符号与预备知识
- 长上下文下标准注意力的问题
- 方向 A:IO 感知的精确注意力
- 方向 B:位置编码与长度外推
- 方向 C:降低每个 token 的 KV 大小——MQA、GQA 与 MLA
- 方向 D:静态稀疏与局部-全局交错注意力
- 方向 E:内容相关的动态稀疏注意力
- 方向 F:序列维 KV 压缩——DeepSeek-V4 的 CSA 与 HCA
- 方向 G:线性注意力与固定大小记忆
- 方向 H:混合架构
- 数值稳定性与训练技术
- 长上下文训练配方
- 对比
- 讨论与展望
- 参考文献
1 引言
1.1 背景
Transformer [Vaswani et al., 2017] 的自注意力让每个 token 和所有历史 token 直接两两交互,因此能做精确的长程检索;这一点与可并行训练一起,是它取代 RNN 的主要原因。但两两交互意味着两件事:
- 训练/预填充(prefill):长度为 \(N\) 的序列要计算 \(N\times N\) 的打分矩阵,计算量为 \(O(N^2)\)。
- 自回归解码(decode):每生成一个 token,都要读取全部历史 key/value。KV cache 的大小和单步读取量都是 \(O(N)\)。
上下文从 4K 增长到 1M(\(250\times\))时,第 1 项的代价增长 \(62{,}500\times\),第 2 项增长 \(250\times\)。在 1M 量级,即使模型只有几十 B 激活参数,注意力也会成为计算、显存和延迟的主导项(第 3 节给出定量分析)。
开源社区的应对没有统一到某一种 attention。2026 年 1 月底到 2 月中旬的三周内,四家主要实验室发布的旗舰模型分别使用了四种不同的注意力:GLM-5 用 MLA + DSA(稀疏),Qwen3.5 用 Gated DeltaNet 与 Gated Attention 的 3:1 混合(线性 + 全注意力),Kimi K2.5 用 MLA(全注意力),MiniMax-M2.5 用标准全注意力。几个月后,DeepSeek-V4 用 CSA/HCA(序列压缩 + 稀疏)把上下文推到 1M,MiniMax-M3 则从全注意力转向了块稀疏的 MSA。这种分化正是本文要梳理的对象。
1.2 主要贡献
- 统一符号:所有方法共用一套记号(第 2.1 节),避免不同论文中 \(c\)、\(k\)、\(m\)、\(G\) 等符号含义冲突。
- 统一框架:把每一层 attention 看作一个“记忆”\(\mathcal{M}_t\) 的写入与读取,用四个设计维度(可见集合、KV 条目表示、KV 条目数量、读出函数)给所有方法定位(第 2.4 节)。
- 问题驱动:先定量分析标准 attention 在长上下文下的六类问题(第 3 节),再说明每个方向分别解决哪个问题、引入了什么新问题,以及这些新问题如何引出下一个方向。
- 完整推导:给出 online softmax 合并、RoPE 外推、MLA 权重吸收、NSA/DSA/MSA 的两阶段选择与 KL 蒸馏、CSA 的重叠压缩与输出端 RoPE、Delta 规则的在线学习解释与 chunkwise(WY/UT)并行算法、线性记忆容量的串扰分析等。
- 模型对照:整理 DeepSeek、Qwen、Kimi、GLM、MiniMax、Llama、Gemma、gpt-oss 等开源模型的注意力配置、上下文长度与训练配方。
1.3 分类体系与路线图
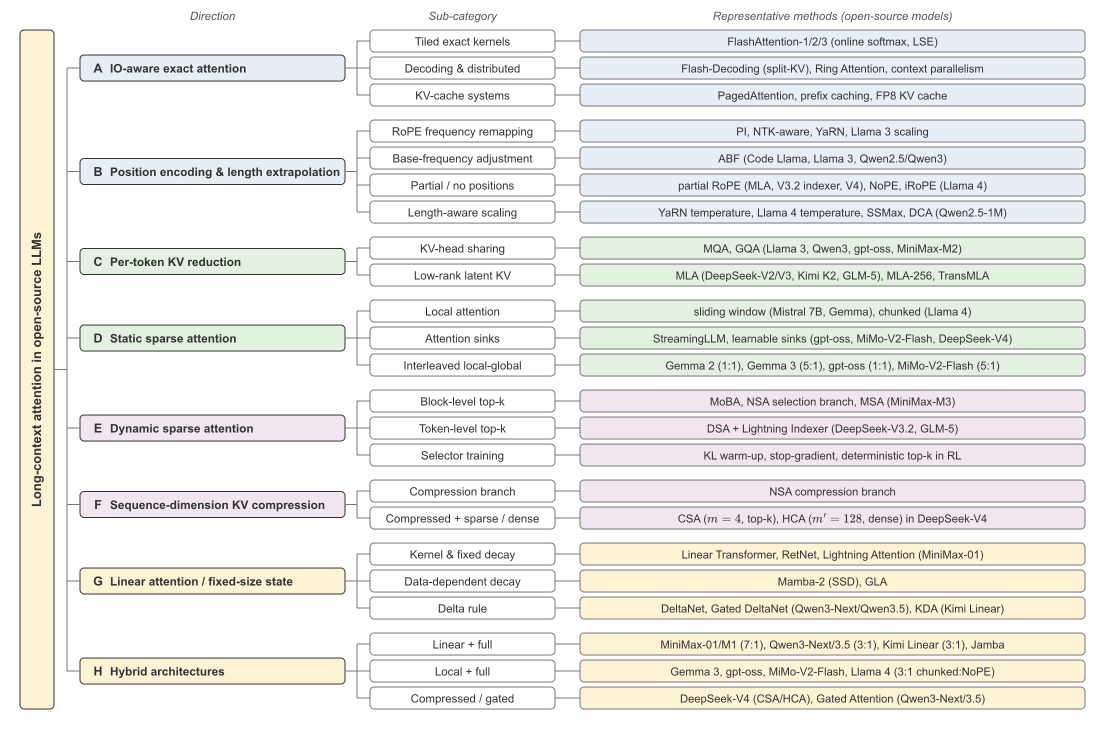
图 1 把本文涉及的方法整理成一个分类体系;下表按方向总结了核心思想、解决的问题,以及遗留或引入的问题。
图 1. 开源 LLM 长上下文注意力机制的分类体系。每个方向(A–H)再细分为子类,并列出代表方法和采用它们的开源模型。
| 方向 | 核心思想 | 代表方法(模型) | 解决 | 遗留 / 引入的问题 |
|---|---|---|---|---|
| A. IO 感知的精确注意力 | 数学不变,用 online softmax 分块计算 | FlashAttention-1/2/3、Flash-Decoding、Ring Attention / CP、PagedAttention | \(O(N^2)\) 显存与 HBM 访存;KV 碎片 | \(O(N^2)\) FLOPs;\(O(N)\) KV cache |
| B. 位置编码与长度外推 | 重映射 RoPE 频率 / 位置;长度相关温度 | PI、NTK-aware、YaRN、Llama 3 缩放、ABF、NoPE / iRoPE、DCA | 训练长度之外的位置 OOD | 计算与显存不变 |
| C. 降低每 token 的 KV | 共享 KV 头,或缓存低秩潜变量 | MQA、GQA(Llama 3、Qwen3、gpt-oss)、MLA(DeepSeek-V3、Kimi K2、GLM-5) | 每 token KV 大小、decode 带宽 | KV cache 仍为 \(O(N)\);prefill 仍为 \(O(N^2)\) |
| D. 静态稀疏注意力 | 与内容无关的可见集合 | SWA、attention sink、chunked attention;局部:全局交错(Gemma 3、gpt-oss、Llama 4) | 局部层的计算与 cache 降为 \(O(w)\) | 远程检索弱;全局层仍是稠密的 |
| E. 动态稀疏注意力 | 廉价打分,再在 top-\(k\) 上做精确注意力 | MoBA、NSA、DSA(DeepSeek-V3.2、GLM-5)、MSA(MiniMax-M3) | 注意力 FLOPs 与读取量;检索近乎无损 | 选择不可导;KV 存储仍为 \(O(N)\);索引器 \(O(N^2)\) |
| F. 序列维 KV 压缩 | 每 \(m\) 个 token 压成一个 KV 条目 | NSA 压缩分支、CSA / HCA(DeepSeek-V4) | 计算、存储、索引都降为 \(1/m\) | 块内细节有损;仍随 \(N\) 增长 |
| G. 线性注意力 / 固定大小状态 | 矩阵状态的递推,带门控或 delta 规则更新 | RetNet、Lightning Attention、Mamba-2、GLA、DeltaNet、Gated DeltaNet、KDA | \(O(N)\) 训练、\(O(1)\) decode 状态 | 记忆容量有限;精确检索弱 |
| H. 混合架构 | 高效层与少量全注意力层混合 | MiniMax-01(7:1)、Qwen3-Next / Qwen3.5(3:1)、Kimi Linear(3:1)、Gemma 3(5:1)、DeepSeek-V4(CSA/HCA) | 省掉全注意力的大部分开销 | 全注意力层仍为 \(O(N^2)\);工程复杂度 |
2 统一符号与预备知识
2.1 符号约定
全文采用列向量约定:粗体小写为向量,粗体大写为矩阵;把序列按行堆叠的矩阵写作 \(\mathbf{Q}\in\mathbb{R}^{N\times d_h}\),其第 \(t\) 行是 \(\mathbf{q}_t^\top\)。记 \([t]=\{1,2,\dots,t\}\)。
| 符号 | 含义 |
|---|---|
| \(N\), \(N_{\text{train}}\) | 上下文长度;训练时的最大长度 |
| \(t\), \(s\) | query 位置;key/value 位置(因果约束 \(s\le t\)) |
| \(d\), \(L\) | 模型隐藏维度;层数 |
| \(H\), \(H_{kv}\), \(g\) | query 头数;KV 头数;组大小 \(g=H/H_{kv}\) |
| \(d_h\), \(d_v\) | query/key 头维度;value 头维度(通常 \(d_v=d_h\)) |
| \(\mathbf{x}_t\in\mathbb{R}^{d}\) | 第 \(t\) 个 token 在当前层的输入隐状态 |
| \(\mathbf{q}_{t,h},\mathbf{k}_{s,h},\mathbf{v}_{s,h}\) | 第 \(h\) 个头的 query/key/value |
| \(\ell_{t,s,h}\), \(a_{t,s,h}\) | 注意力 logit;softmax 后的注意力权重 |
| \(\mathbf{o}_{t,h}\), \(\mathbf{y}_t\) | 头输出;层输出 |
| \(\mathcal{V}_t\subseteq[t]\) | query \(t\) 的可见集合 |
| \(\mathcal{M}_t\) | 位置 \(t\) 处该层的“记忆” |
| \(e\) | 每个元素的字节数(BF16 为 2,FP8 为 1) |
| \(w\) | 滑动窗口大小 |
| \(B\), \(n_B\) | 块大小;块数 \(n_B=\lceil N/B\rceil\) |
| \(\mathcal{G}_j\) | 第 \(j\) 个块(或压缩组)包含的 token 下标集合 |
| \(k_{\text{top}}\) | 稀疏注意力中选中的 token 数或块数 |
| \(m\), \(m'\) | 序列压缩率(每 \(m\) 个 token 压成 1 个KV 条目) |
| \(d_c\), \(d_q\), \(d_R\) | MLA 的 KV 潜变量维度;query 潜变量维度;解耦 RoPE 维度 |
| \(d_e\) | DeepSeek-V4 中共享 KV 条目的维度 |
| \(I_{t,j}\), \(H_I\), \(d_I\) | 索引器(indexer)分数;索引器头数;索引器头维度 |
| \(\mathbf{S}_t\in\mathbb{R}^{d_k\times d_v}\) | 线性注意力的矩阵状态(\(d_k=d_h\)) |
| \(\alpha_t\), \(\boldsymbol{\alpha}_t\), \(\beta_t\) | 标量遗忘门;通道级遗忘门;Delta 写入强度 |
| \(C\) | chunkwise 算法的块长度 |
| \(\mathbf{R}_t\), \(\theta_i\), \(b\) | RoPE 旋转矩阵;第 \(i\) 个频率;RoPE base |
| \(\rho\) | 上下文扩展倍数 \(\rho=N_{\text{target}}/N_{\text{train}}\) |
| \(\sigma(\cdot)\), \(\odot\) | sigmoid;逐元素乘 |
为避免歧义,“top-k”中的个数统一记作 \(k_{\text{top}}\),不与 key 向量 \(\mathbf{k}\) 混淆;不同论文中的压缩率(DeepSeek-V4 原文的 \(m\)、\(c\))统一记作 \(m\);KV 条目维度(V4 原文的 \(c\))统一记作 \(d_e\)。
2.2 标准多头注意力(MHA)
对第 \(h\) 个头:
注意力 logit、权重与输出为
因果语言模型取 \(\mathcal{V}_t=[t]\)。矩阵形式为
后文所有稀疏方法本质上都是在修改 \(\mathcal{V}_t\)(即修改掩码 \(\mathbf{M}\)),所有压缩方法都是在修改 \((\mathbf{k},\mathbf{v})\) 的来源,线性方法则修改 softmax 本身。
2.3 Prefill、Decode 与 KV cache
自回归推理分两个阶段:
- Prefill:一次性处理长度为 \(N\) 的 prompt,所有位置并行计算,属于计算密集型(compute-bound)。
- Decode:每步生成 1 个 token,新 query 要与全部历史 key/value 交互。为避免重复计算,历史的 \(\mathbf{k}_{s,h},\mathbf{v}_{s,h}\) 被缓存,即 KV cache。
KV cache 的总字节数为
单层单步 decode 的注意力计算量与读取量为
因此算术强度(arithmetic intensity)为
对 BF16 的 MHA(\(g=1,e=2\)),\(\mathcal{I}_{\text{dec}}\approx 1\) FLOP/Byte,而 H100 的计算/带宽比约为 \(989\ \text{TFLOPS}/3.35\ \text{TB/s}\approx 295\) FLOP/Byte。也就是说,decode 时 GPU 绝大部分时间在等显存。式 (2.7) 是理解 GQA/MLA 的关键:增大 \(g\) 或让所有头共享同一份 KV,可以直接提高算术强度。
2.4 统一框架:注意力是一个记忆的写入与读取
把每层、每个头看作维护一个记忆 \(\mathcal{M}_t\):
标准 attention 的写入 \(\mathcal{W}\) 是“追加一条 \((\mathbf{k}_t,\mathbf{v}_t)\)”,读取 \(\mathcal{R}\) 是 softmax 核平滑,记忆大小为 \(|\mathcal{M}_t|=O(t)\)。线性注意力的写入是秩一更新 \(\mathbf{S}_t=\mathbf{S}_{t-1}+\mathbf{k}_t\mathbf{v}_t^\top\),读取是 \(\mathbf{S}_t^\top\mathbf{q}_t\),记忆大小为 \(O(d_kd_v)\),与 \(t\) 无关。其余方法都介于这两个极端之间。
更具体地,几乎所有 softmax 类方法都可以写成下面的通用形式:
其中:
- \(\mathcal{G}_j\) 是第 \(j\) 个KV 条目由哪些 token 生成(标准 attention 中 \(\mathcal{G}_j=\{j\}\);序列压缩中 \(|\mathcal{G}_j|=m\));
- \(\phi\) 是KV 条目的表示方式(每个头独立的 \(\mathbf{k},\mathbf{v}\);GQA 中组内共享;MLA 中的低秩潜变量;V4 中 key/value 共享同一个向量);
- \(\mathcal{J}_t\) 是 query \(t\) 可读的KV 条目集合(全部、窗口、top-k 选择);
- \(\varsigma_h\) 是可选的 attention sink logit(取 \(-\infty\) 时退化为标准 softmax)。
由此得到四个正交的设计维度:
| 设计维度 | 数学对象 | 典型选择 | 主要影响 |
|---|---|---|---|
| ① 可见集合 | \(\mathcal{J}_t\) | 全部 / 窗口 / 固定模式 / top-k | 计算量 |
| ② 条目表示 | \(\phi\) 的输出维度 | MHA / GQA / MQA / MLA / 共享 KV | 每个条目的 cache 大小、decode 带宽 |
| ③ 条目数量 | \(\lvert\{\mathcal{G}_j\}\rvert\) | \(N\) / \(N/m\) / \(w\) / 固定状态 | cache 随 \(N\) 的增长速度 |
| ④ 读出函数 | softmax / 线性核 / 门控 | softmax、sink、output gate、linear | 精确检索能力、能否写成递推 |
表 1 是主要方法在这四个维度上的位置(细节见对应章节):
| 方法 | ① \(\mathcal{J}_t\) | ② 条目表示 | ③ 条目数 | ④ 读出 |
|---|---|---|---|---|
| MHA | \([t]\) | 每头独立 \(\mathbf{k},\mathbf{v}\) | \(t\) | softmax |
| GQA / MQA | \([t]\) | 组内共享 / 全部共享 | \(t\) | softmax |
| MLA | \([t]\) | 低秩潜变量 \(\mathbf{c}^{KV}\) | \(t\) | softmax |
| SWA | \(\{t-w+1,\dots,t\}\) | 同底座 | \(\min(t,w)\) | softmax |
| StreamingLLM | sink \(\cup\) 窗口 | 同底座 | \(n_0+w\) | softmax |
| MoBA / MSA | top-\(k_{\text{top}}\) 块 \(\cup\) 局部块 | 原始 KV | \(t\)(只读一部分) | softmax |
| DSA | top-\(k_{\text{top}}\) token | MLA 潜变量 | \(t\)(只读一部分) | softmax |
| NSA | 压缩 \(\cup\) 选择 \(\cup\) 窗口 | 原始 + 压缩 KV | \(t+t/\delta\) | 门控融合三路 softmax |
| CSA (V4) | top-\(k_{\text{top}}\) 压缩条目 \(\cup\) 窗口 \(\cup\) sink | 共享 KV,\(m\) 个 token 压成 1 个 | \(t/m\) | softmax + sink |
| HCA (V4) | 全部压缩条目 \(\cup\) 窗口 \(\cup\) sink | 共享 KV,\(m'\) 个 token 压成 1 个 | \(t/m'\) | softmax + sink |
| 线性注意力族 | 隐式全部 | 矩阵状态 \(\mathbf{S}_t\) | 1 个 \(d_k\times d_v\) 状态 | 线性读取 \(\mathbf{S}_t^\top\mathbf{q}_t\) |
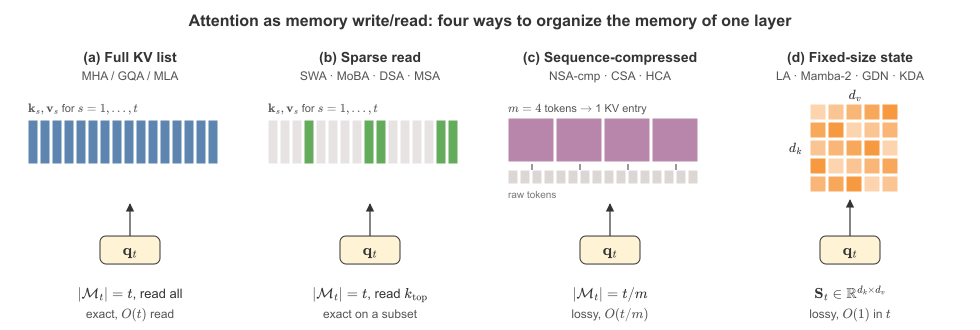
图 2. 把注意力看作记忆的写入与读取(第 2.4 节):(a) 完整 KV 列表;(b) 只读取其中一个子集;(c) 沿序列维度压缩;(d) 固定大小的矩阵状态。
3 长上下文下标准注意力的问题
本节定量说明标准 attention 在长上下文下的六个问题(P1–P6)。后续每个方向都是针对其中一个或几个问题。
3.1 P1:计算量随 \(N^2\) 增长
每层每个 token 的线性投影与 FFN 计算量和 \(N\) 无关。以 MHA(\(Hd_h=d\))加 SwiGLU FFN(\(d_{\text{ff}}=\tfrac{8}{3}d\))为例:
因果注意力对第 \(t\) 个 token 的计算量为 \(4d\,t\)(\(\mathbf{q}^\top\mathbf{K}\) 与 \(\mathbf{a}^\top\mathbf{V}\) 各 \(2dt\)),平均 \(t=N/2\) 时为 \(2dN\)。两者之比为
当 \(N>12d\) 时注意力开始主导。\(d=4096\) 时临界长度约为 \(49\)K;在 \(N=1\)M 时注意力计算是其余部分的约 \(20\) 倍。对 MoE 模型,FFN 只激活一小部分参数,临界长度更早到来。整段 prefill 的注意力计算量为
3.2 P2:KV cache 显存与 decode 带宽随 \(N\) 增长
把式 (2.5) 代入几种典型配置(BF16,\(e=2\);\(1\text{M}\approx 2^{20}\)):
| 配置 | 每 token 每层元素数 | 每 token(全模型) | 128K 上下文 | 1M 上下文 |
|---|---|---|---|---|
| MHA, \(L{=}80,H{=}64,d_h{=}128\) | \(2Hd_h=16384\) | 2.5 MiB | 320 GiB | 2.5 TiB |
| GQA-8, \(L{=}80,H_{kv}{=}8,d_h{=}128\) | \(2H_{kv}d_h=2048\) | 320 KiB | 40 GiB | 320 GiB |
| MLA, \(L{=}61,d_c{=}512,d_R{=}64\) | \(d_c+d_R=576\) | 68.6 KiB | 8.6 GiB | 68.6 GiB |
即使是 GQA,1M 上下文的单条序列 cache 也超过单卡 HBM 容量。另外,由式 (2.6)–(2.7),decode 每步都要把整个 cache 从 HBM 读一遍,单步延迟随 \(N\) 线性增长,batch 越大,带宽压力越大。
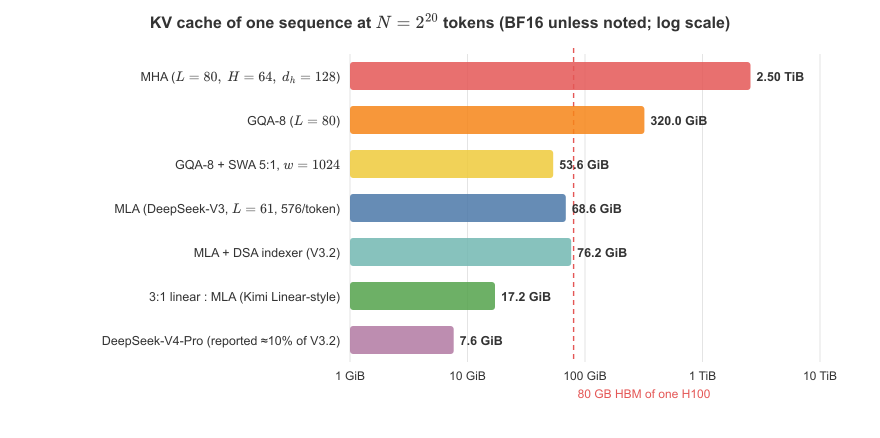
图 3. 几种典型配置下,单条 1M token 序列的 KV cache 大小(式 2.5;除 FP8 索引器 key 外均为 BF16)。虚线是一张 H100 的 80 GB HBM。
3.3 P3:位置编码的分布外(OOD)问题
主流开源模型使用 RoPE(第 5 节)。其第 \(i\) 个二维子空间以频率 \(\theta_i=b^{-2i/d_h}\) 旋转,波长为 \(\lambda_i=2\pi/\theta_i\)。当 \(\lambda_i>N_{\text{train}}\) 时,这个维度在训练中从未转完一整圈,推理时 \(t\theta_i\) 超过训练见过的角度范围,模型对这些相位组合是外推。满足 \(\lambda_i>N_{\text{train}}\) 的维度编号为
例如 \(b=10^4\)、\(d_h=128\)、\(N_{\text{train}}=4096\) 时,\(i>0.70\times 64\approx 45\),即 64 个频率对中约 19 个是“未完整训练”的低频维度。直接把这样的模型用在 \(4\times N_{\text{train}}\) 上,困惑度会迅速上升。
3.4 P4:注意力稀释
softmax 权重之和为 1。设目标 key 的 logit 比其余 \(N-1\) 个干扰 key 高 \(\Delta\),则目标权重为
要让 \(a_{\text{target}}\ge\tfrac12\),需要 \(\Delta\ge\ln(N-1)\)。也就是说,同样的检索精度要求 logit 间隔随 \(\ln N\) 增长。训练在 \(N_{\text{train}}\) 下学到的 logit 尺度,到 \(\rho N_{\text{train}}\) 时不够用,注意力分布变平,熵变大。这解释了 YaRN 的温度缩放、Llama 4 的推理期温度调节和 Scalable-Softmax 的 \(\log N\) 因子(第 5.6 节),也部分解释了“lost in the middle”现象 [Liu et al., 2023]。
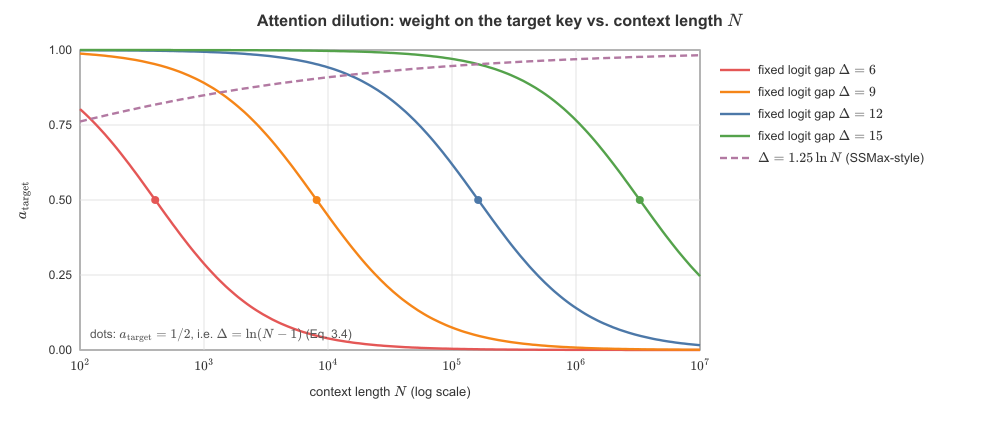
图 4. 注意力稀释(式 3.4)。logit 间隔固定时,\(N\) 超过约 \(e^{\Delta}\) 后目标权重迅速下降;让间隔随 \(\ln N\) 增长(YaRN 温度、Llama 4 温度、SSMax)可以保持稳定。
3.5 P5:Attention sink 与 massive activations
softmax 强制 \(\sum_s a_{t,s,h}=1\),于是一个“当前不需要读取任何信息”的头,必须把权重放到某处。训练中模型会把多余的权重集中在第一个 token(或分隔符)上,形成 attention sink [Xiao et al., 2023],并伴随残差流中的 massive activations [Sun et al., 2024]。这带来两个长上下文问题:(i) 滑动窗口一旦驱逐了 sink token,模型就会崩溃;(ii) 极端激活值与很大的 logit 会损害低精度(FP8/FP4)计算,使训练不稳定。对应的解决方法有可学习 sink、output gate、QK-Norm 等(第 7.2、11.3、12 节)。
3.6 P6:训练代价与训练–推理不一致
在 \(N\) 长度上训练的代价同样服从式 (3.2),而高质量长文档数据稀少,因此几乎所有模型都采用“短上下文预训练 + 分阶段扩展”的配方(第 13 节)。另外,稀疏/压缩注意力往往由稠密模型转化而来,引入 top-k 选择后,如何训练不可导的选择器、如何保证 RL 中训练与推理的选择一致,都是新问题(第 8.6 节)。
3.7 问题与方向的对应
| 问题 | A IO 感知 | B 位置外推 | C 每 token KV | D 静态稀疏 | E 动态稀疏 | F 序列压缩 | G 线性 | H 混合 |
|---|---|---|---|---|---|---|---|---|
| P1 计算 \(O(N^2)\) | 只降 IO | – | – | ✔ | ✔ | ✔ | ✔ | ✔ |
| P2 KV cache / 带宽 | 分页管理 | – | ✔ | ✔ | 只降读取量 | ✔ | ✔ | ✔ |
| P3 位置 OOD | – | ✔ | – | 局部层天然规避 | – | – | 递推隐式编码位置 | NoPE 全局层 |
| P4 注意力稀释 | – | 温度缩放 | – | – | 只在 top-k 内归一化 | – | 门控遗忘 | – |
| P5 sink / 数值 | – | – | – | 可学习 sink | – | sink + RMSNorm | 无 softmax | output gate |
| P6 训练 | Ring/CP | 分阶段 | – | – | KL 蒸馏 warmup | warmup | chunkwise 并行 | 蒸馏改造 |
表中“只降读取量”指动态稀疏(如 DSA)只读取 \(k_{\text{top}}\) 个 KV,但仍需存储全部 KV;这一点正是方向 F 要进一步解决的。
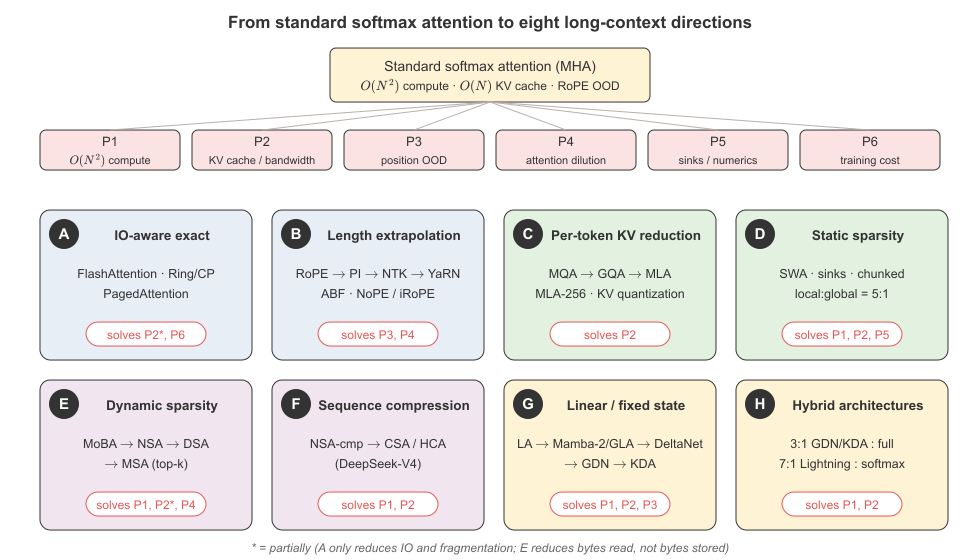
图 5. 从标准 softmax attention 到八个方向:六类长上下文问题(P1–P6)以及分别解决它们的方向。
4 方向 A:IO 感知的精确注意力
这一方向不改变式 (2.2) 的输出,只改变计算顺序与数据搬运方式。它是其他所有方向的工程基础:后文的稀疏、压缩方法几乎都以 FlashAttention 风格的 kernel 实现。
4.1 Online softmax 与 FlashAttention
朴素实现会把 \(N\times N\) 的打分矩阵写回 HBM,显存为 \(O(N^2)\),IO 量巨大。FlashAttention [Dao et al., 2022] 的核心是 online softmax:把 key/value 按块 \(\mathcal{G}_1,\mathcal{G}_2,\dots\) 依次读入 SRAM,对每个 query 维护三个运行量——当前最大 logit \(\mu\)、归一化分母 \(\zeta\)、未归一化输出 \(\mathbf{u}\):
初值取 \(\mu^{(0)}=-\infty,\ \zeta^{(0)}=0,\ \mathbf{u}^{(0)}=\mathbf{0}\)。用归纳法可直接验证 \(\mathbf{u}^{(j)}/\zeta^{(j)}\) 恰好等于只在前 \(j\) 块上做 softmax 的结果,因此最终输出与式 (2.2) 逐位相等(在浮点误差内)。
反向传播时,只保存每个 query 的 log-sum-exp
即可按 \(a_{t,s}=\exp(\ell_{t,s}-\operatorname{LSE}_t)\) 在 SRAM 中重算注意力权重,不需要保存 \(N\times N\) 矩阵。设 SRAM 容量为 \(M_{\text{sram}}\),FlashAttention 的 HBM 访问量为 \(O\!\big(N^2d_h^2/M_{\text{sram}}\big)\),而朴素实现为 \(O(N d_h+N^2)\)。额外显存降为 \(O(N)\)。FlashAttention-2/3 [Dao, 2023; Shah et al., 2024] 进一步优化了并行划分、warp 特化、异步拷贝和 FP8。
结论:FlashAttention 把注意力的显存从 \(O(N^2)\) 降为 \(O(N)\),但计算量仍然是式 (3.2) 的 \(O(N^2)\),也不改变 KV cache。
4.2 Log-Sum-Exp 合并:反复用到的工具
式 (4.1) 的一个推论是:如果把可见集合拆成不相交的两部分 \(\mathcal{V}_t=\mathcal{A}\cup\mathcal{B}\),分别算出局部输出 \(\mathbf{o}^{\mathcal{A}},\mathbf{o}^{\mathcal{B}}\) 和局部 \(\operatorname{LSE}^{\mathcal{A}},\operatorname{LSE}^{\mathcal{B}}\),那么全局结果可以精确合并:
式 (4.3) 是以下技术的共同数学基础:
- FlashDecoding / Split-KV:decode 时只有 1 个 query,按序列维度把 KV 切成 \(P\) 段并行计算,再用式 (4.3) 合并,以提高 GPU 利用率。
- Ring Attention / Context Parallel [Liu et al., 2023]:\(P\) 张卡各持有 \(N/P\) 个 token,KV 块沿环形拓扑传递,每张卡用式 (4.3) 累积。每卡显存为 \(O(N/P)\),通信可与计算重叠。这是 128K–1M 长度训练的标准做法。
- Attention sink:式 (2.9) 中的 \(\exp(\varsigma_h)\) 可以看作只有一个“空值”(\(\mathbf{v}=\mathbf{0}\))的集合 \(\mathcal{B}\),合并后只是分母多一项(第 7.2 节)。
- 多分支稀疏注意力:DeepSeek-V4 把压缩 KV 与滑动窗口 KV 放进同一个 softmax,本质上就是式 (4.3)(第 9 节)。
4.3 分页 KV cache 管理与 KV cache 量化
PagedAttention [Kwon et al., 2023] 借鉴操作系统虚拟内存:把 KV cache 切成固定大小的物理页,每条序列维护一张逻辑页 → 物理页的映射表。这样可以消除内部碎片,并让共享前缀的多条序列共享物理页(prefix caching),对多轮 agent 和 RL rollout 尤其重要。GLM-5 的 RL 系统用一致性哈希把同一 rollout 固定路由到同一个 DP rank,也是为了最大化前缀 KV 复用。
KV 量化 把式 (2.5) 中的 \(e\) 从 2 降到 1(FP8)甚至 0.5(INT4/FP4)。DeepSeek-V3.2 的索引器 key 以 FP8 存储;DeepSeek-V4 对 KV 条目的 RoPE 维度用 BF16、其余维度用 FP8。
4.4 小结与遗留问题
方向 A 解决了“\(N\times N\) 矩阵放不下”的显存问题,但没有解决 P1(FLOPs 仍为 \(O(N^2)\))和 P2(KV cache 仍为 \(O(L H_{kv} d_h N)\)),也没有解决 P3(位置外推)。下一节先处理 P3,因为它决定模型在长上下文中“能不能用”;之后的方向 C–H 再处理“用得起”的问题。
5 方向 B:位置编码与长度外推
5.1 RoPE
旋转位置编码(RoPE)[Su et al., 2021] 把 \(d_h\) 维向量分成 \(d_h/2\) 个二维子空间,第 \(i\) 个子空间以频率
旋转。位置 \(t\) 的旋转矩阵是块对角矩阵
query 与 key 分别旋转后再做内积:
这里用到了 \(\mathbf{R}_t^\top\mathbf{R}_s=\mathbf{R}_{s-t}\)(旋转矩阵正交且同轴旋转可加)。因此 logit 只依赖相对距离 \(t-s\)。把 \(\mathbf{q},\mathbf{k}\) 的第 \(i\) 个子空间写成复数 \(q^{(i)},k^{(i)}\in\mathbb{C}\),有
高频维度(\(i\) 小,\(\theta_i\) 大)随距离快速振荡,编码局部位置;低频维度(\(i\) 大)变化缓慢,编码远距离位置。
5.2 外推失败的原因
由式 (3.3),低频维度在训练中没有转完一圈。推理到 \(N>N_{\text{train}}\) 时,这些维度出现训练中从未见过的相位 \((t-s)\theta_i\),logit 分布偏离训练分布,困惑度迅速上升。所有 RoPE 扩展方法都可以写成对频率的重映射
目标是让推理时每个维度的相位范围 \(\{(t-s)\theta_i'\,:\,|t-s|<N_{\text{target}}\}\) 落在训练见过的范围内,同时尽量不破坏高频维度的局部分辨率。
5.3 Position Interpolation(PI)与 NTK-aware 缩放
Position Interpolation(PI) [Chen et al., 2023] 把所有维度都等比压缩:
所有相位都落在训练范围内,但高频维度的分辨率也被压缩了 \(\rho\) 倍,相邻 token 更难区分,需要微调来恢复。
NTK-aware 缩放 改为调整 base,使最高频不变、最低频恰好被压缩 \(\rho\) 倍:
验证:\(i=0\) 时 \(\theta_0'=1=\theta_0\);\(i=\tfrac{d_h}{2}-1\) 时 \(\theta_i'=b^{-(d_h-2)/d_h}\rho^{-1}=\theta_i/\rho\)。中间维度按几何级数平滑过渡。NTK-aware 方法不微调也能部分外推。
5.4 YaRN 与 Llama 3 缩放:NTK-by-parts 插值
更精细的做法是按每个维度的“训练中转了几圈”分别处理。定义第 \(i\) 个维度在训练长度内的圈数
再定义斜坡函数(阈值 \(\alpha_{\text{lo}}<\beta_{\text{hi}}\))
YaRN [Peng et al., 2023] 的“NTK-by-parts”插值为
含义是:转了很多圈的高频维度(\(r_i>\beta_{\text{hi}}\))完全不动,保留局部分辨率;一圈都没转完的低频维度(\(r_i<\alpha_{\text{lo}}\))完全插值,避免 OOD;中间线性过渡。YaRN 推荐 \(\alpha_{\text{lo}}=1,\beta_{\text{hi}}=32\)。
为对抗插值后注意力分布变平(P4),YaRN 同时引入注意力温度:
实现时把 \(\mathbf{q}\) 与 \(\mathbf{k}\) 都乘以 \(\sqrt{1/\tau}\)。DeepSeek-V3 用 YaRN(\(\rho=40\),\(N_{\text{train}}=4\text{K}\))分两阶段扩展到 32K 和 128K;Qwen2.5/Qwen3 用 YaRN 把 32K 扩展到 128K;Kimi K2 也采用 YaRN。
Llama-3.1 缩放 是式 (5.10) 的一个变体:用波长而非圈数设阈值。设 \(N_{\text{orig}}=8192\),\(\rho=8\),低/高频因子 \(f_{\text{lo}}=1,f_{\text{hi}}=4\):
注意 \(N_{\text{orig}}/\lambda_i=r_i\),所以式 (5.12) 正是 \(\alpha_{\text{lo}}=1,\beta_{\text{hi}}=4\) 时的式 (5.10),只是不带温度项。
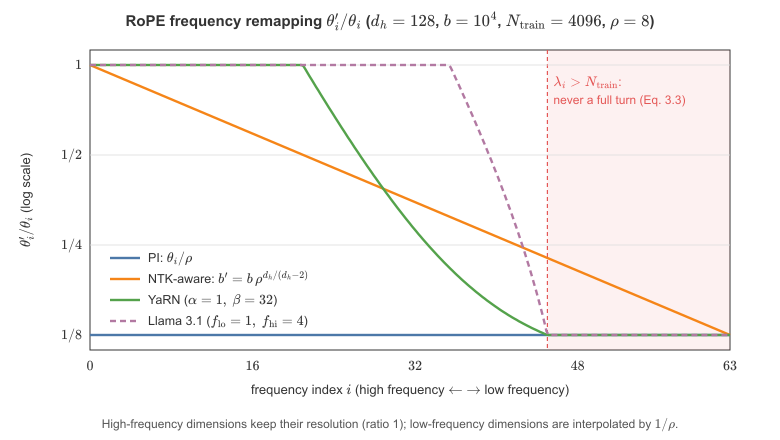
图 6. PI(式 5.6)、NTK-aware(式 5.7)、YaRN(式 5.10)与 Llama 3.1 缩放(式 5.12)下各维度的频率比 \(\theta'_i/\theta_i\)。阴影区域是在 \(N_{\text{train}}\) 内转不满一圈的维度(式 3.3)。
5.5 调整基频(ABF)
另一种思路是在长上下文继续预训练时直接把 \(b\) 调大(adjusted base frequency, ABF)[Xiong et al., 2023]。由式 (3.3),增大 \(b\) 等价于让更多维度在训练长度内“转不完一圈”,但这些维度的相位变化很慢,在更长距离上仍处于小角度区域,因此对外推更友好。代表性配置:
| 模型 | RoPE base | 说明 |
|---|---|---|
| Llama 2 | \(10^4\) | 4K |
| Code Llama | \(10^6\) | 16K 训练,外推到 100K |
| Llama 3 / 3.1 | \(5\times10^5\) | 3.1 另加式 (5.12) 缩放到 128K |
| Qwen2.5 / Qwen3 | \(10^6\) | 再叠加 YaRN |
| Gemma 3 | 局部层 \(10^4\);全局层 \(10^6\) | 局部层不需要外推 |
Gemma 3 的配置说明了一个规律:只有需要看远处的层才需要处理外推。滑动窗口层永远只看 \(w\) 以内的距离,用小 base 获得更高的局部分辨率即可。
5.6 部分 RoPE、NoPE 与长度相关的注意力温度
部分 RoPE:只对一部分维度施加旋转,其余维度不编码位置。MLA 的解耦 RoPE(第 6.4 节)、DeepSeek-V3.2 的索引器(128 维中 64 维施加 RoPE)、DeepSeek-V4 的 CSA/HCA(最后 64 维施加 RoPE)都是这种形式。不编码位置的维度可以做纯语义匹配,不受外推影响。
NoPE:完全不加位置编码。因果掩码本身就泄露了位置信息(第 \(t\) 个 query 恰好看到 \(t\) 个 key),因此 decoder-only 模型在 NoPE 下仍能学到位置。NoPE 层没有 RoPE 的 OOD 问题,但它没有天然的距离衰减,长上下文时 P4 更严重。两个代表:
- Llama 4(iRoPE):局部层使用 RoPE 的 chunked attention(块大小 8192),每 4 层有 1 层是 NoPE 全局注意力。推理时对 NoPE 层的 query 施加随位置增长的温度:
$$ \mathbf{q}_t\ \mapsto\ \Big(1+\varepsilon_{\tau}\ln\!\Big(\Big\lfloor\frac{t+1}{N_\tau}\Big\rfloor+1\Big)\Big)\,\mathbf{q}_t, \tag{5.13} $$其中 \(N_\tau=8192,\ \varepsilon_\tau=0.1\)(Hugging Face 实现中的
floor_scale与attn_scale)。这正是对式 (3.4) 中“所需 logit 间隔随 \(\ln N\) 增长”的直接补偿。 - Kimi Linear:全注意力的 MLA 层使用 NoPE,位置信息和近因偏置交给 KDA 层的数据相关衰减(第 10 节)。
Scalable-Softmax(SSMax) [Nakanishi, 2025] 把同样的思想写进训练:\(\ell_{t,s}\mapsto \varpi\,(\ln|\mathcal{V}_t|)\,\ell_{t,s}\),其中 \(\varpi\) 为可学习标量。由式 (3.4),乘以 \(\ln N\) 后,目标权重 \(a_{\text{target}}\) 在不同长度下保持稳定。
5.7 Dual Chunk Attention:重映射相对位置
Qwen2.5-1M [Yang et al., 2025] 在推理时结合 YaRN 与 Dual Chunk Attention(DCA) [An et al., 2024],免训练地把 256K 训练长度外推到 1M。DCA 把序列按块长 \(B\) 切块,由三部分组成:块内注意力(intra-chunk)保留原始相对位置;块间注意力(inter-chunk)在 query 关注更早块的 key 时,给 query 赋一个固定的较大位置下标,使所有相对距离都落在预训练范围内;相邻块注意力(successive-chunk)对紧邻的前一块使用专门的位置分配,以保持局部连续性。它属于“重映射 \((t-s)\)”,与式 (5.5) 的“重映射 \(\theta_i\)”互补。
5.8 小结与遗留问题
方向 B 让模型在 \(N\gg N_{\text{train}}\) 时仍“看得懂”位置,但完全没有改变计算量与显存:一个能读 1M token 的 RoPE-YaRN 模型,在 1M 上的 prefill 仍是 \(O(N^2)\),KV cache 仍按第 3.2 节的表增长。另外,外推只能免训练地扩展有限倍数,可靠的长上下文能力仍需要在目标长度上训练,而这又回到了 P1/P6。接下来的方向 C–H 都在回答:如何让长上下文在计算和显存上可负担。
6 方向 C:降低每个 token 的 KV 大小——MQA、GQA 与 MLA
本方向不改变 \(\mathcal{J}_t=[t]\),也不改变 softmax,只缩小每个KV 条目的大小(框架维度 ②)。它针对 P2:KV cache 显存与 decode 带宽。
6.1 MQA 与 GQA
多查询注意力(MQA) [Shazeer, 2019] 让所有 query 头共享一对 key/value 头:\(\mathbf{k}_{s,h}\equiv\mathbf{k}_s,\ \mathbf{v}_{s,h}\equiv\mathbf{v}_s\)。分组查询注意力(GQA) [Ainslie et al., 2023] 是中间形态:把 \(H\) 个 query 头分成 \(H_{kv}\) 组,每组 \(g=H/H_{kv}\) 个头共享一对 KV。记第 \(h\) 个 query 头所属的组为
则
MHA 是 \(H_{kv}=H\),MQA 是 \(H_{kv}=1\)。KV cache 按式 (2.5) 缩小为原来的 \(H_{kv}/H=1/g\);由式 (2.7),decode 的算术强度提高到 \(2g/e\)。GQA 已是开源模型的默认配置,例如 Llama-3-70B(\(H=64,H_{kv}=8\))、Llama-3.1-405B(\(H=128,H_{kv}=8\))、Qwen3-235B-A22B(\(H=64,H_{kv}=4\))、gpt-oss(\(H=64,H_{kv}=8\))。已训练好的 MHA 模型也可以把同组 KV 投影矩阵取平均得到 GQA 初始化,再少量继续训练(uptraining)。
GQA 的代价是表达能力:组内 \(g\) 个头只能对同一组 key 做不同的 query 查询,读到的是同一组 value 的不同加权组合。\(g\) 太大时质量下降。
6.2 MLA:低秩联合 KV 压缩
多头潜变量注意力(MLA) [DeepSeek-AI, 2024a; 2024b] 换了一种思路:不让头共享 KV,而是让所有头的 KV 都由一个低维潜变量生成,cache 只存这个潜变量。
KV 侧(不含位置):
其中 \(\mathbf{W}^{DKV}\in\mathbb{R}^{d_c\times d}\) 为下投影,\(\mathbf{W}^{UK}_h\in\mathbb{R}^{d_h\times d_c}\)、\(\mathbf{W}^{UV}_h\in\mathbb{R}^{d_v\times d_c}\) 为每个头的上投影。query 侧也做低秩分解以节省训练激活:\(\mathbf{c}^{Q}_t=\mathbf{W}^{DQ}\mathbf{x}_t\in\mathbb{R}^{d_q}\),\(\mathbf{q}^{C}_{t,h}=\mathbf{W}^{UQ}_h\mathbf{c}^{Q}_t\)。DeepSeek-V3 中 \(d=7168,\ H=128,\ d_h=d_v=128,\ d_c=512,\ d_q=1536\)(实现中 \(\mathbf{c}^{KV}\)、\(\mathbf{c}^{Q}\) 后各有一个 RMSNorm,下文略去)。
6.3 权重吸收:MLA 在 decode 时等价于宽 MQA
不考虑位置时,第 \(h\) 个头的 logit 为
输出端同理:
因此 decode 时不需要把 \(\mathbf{c}^{KV}\) 展开成每个头的 \(\mathbf{k},\mathbf{v}\):每个头先把 query 映射到潜空间得到 \(\hat{\mathbf{q}}_{t,h}\),直接与缓存的 \(\mathbf{c}^{KV}_s\) 做内积并加权求和,最后再由吸收后的 \(\mathbf{W}^{O}_h\mathbf{W}^{UV}_h\) 投影回 \(d\) 维。这在数学上就是一个 \(H\) 个 query 头共享同一个 key/value(都等于 \(\mathbf{c}^{KV}_s\))的 MQA,只是 key/value 维度为 \(d_c\)。
训练与 prefill 时,计算量受 \(N^2\) 主导,此时更省的做法是把 \(\mathbf{c}^{KV}\) 展开成标准 MHA(每头 \(d_h+d_R=192\) 维 qk、\(d_v=128\) 维 v);decode 时受带宽主导,使用式 (6.4)–(6.5) 的吸收形式。同一组权重,两种计算顺序,这是 MLA 工程实现的核心。
6.4 解耦 RoPE
RoPE 与权重吸收不兼容。若直接对 \(\mathbf{q}^{C}\) 和 \(\mathbf{k}^{C}\) 施加 RoPE,由式 (5.3),
位置相关的 \(\mathbf{R}_{s-t}\) 夹在两个投影矩阵之间,无法预先合并成一个与位置无关的矩阵。解决方法是解耦:额外开一条低维通道专门携带位置,所有头共享同一个 RoPE key:
第一项用式 (6.4) 吸收,第二项是一个 \(d_R\) 维的普通 MQA 内积。cache 中每个 token 每层只需存 \([\mathbf{c}^{KV}_s;\mathbf{k}^{R}_s]\),共 \(d_c+d_R=576\) 个元素(DeepSeek-V3 中 \(d_R=64\))。
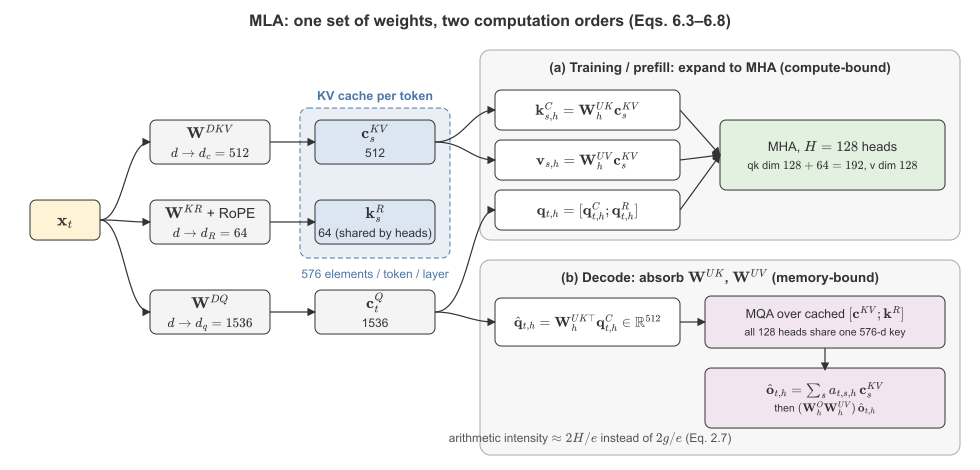
图 7. MLA 的数据流。cache 中只存 \([\mathbf{c}^{KV};\mathbf{k}^{R}]\)(576 个元素)。(a) 训练 / prefill 时把潜变量展开成标准 MHA;(b) decode 时把 \(\mathbf{W}^{UK}\) 吸收进 query、把 \(\mathbf{W}^{UV}\) 吸收进输出投影,MLA 变成一个 key 为 576 维的 MQA(式 6.4–6.8)。
6.5 MLA 的代价分析
KV cache. 每 token 每层元素数:
(按 DeepSeek-V3 的 \(H=128,d_h=128\) 计算 MHA。)MLA 相对同头数 MHA 压缩约 57 倍,比 GQA-8 还小 3.6 倍。
表达能力. GQA 是 MLA 的一个特例:取 \(d_c=2H_{kv}d_h\),令 \(\mathbf{c}^{KV}_s=[\mathbf{k}_{s,1};\dots;\mathbf{k}_{s,H_{kv}};\mathbf{v}_{s,1};\dots;\mathbf{v}_{s,H_{kv}}]\),并让 \(\mathbf{W}^{UK}_h,\mathbf{W}^{UV}_h\) 为选出第 \(\pi(h)\) 组的 0/1 选择矩阵,式 (6.3) 就退化为式 (6.2)。因此在相同 cache 预算下,MLA 的函数类严格包含 GQA [Meng et al., 2025, TransMLA]。这也给出了把现有 GQA 模型转换为 MLA 的路径。
Decode 计算量. 吸收后每个头的 key 维度是 \(d_c+d_R\)、value 维度是 \(d_c\),单层单步 decode 计算量为
DeepSeek-V3 的参数下,每个头的 decode 计算量是 GQA(\(d_h=128\))的 \(1088/256\approx 4.25\) 倍。MLA 用计算换带宽,非常适合带宽受限的 decode,但当 batch 很大或使用投机解码(每步多个 query)时,decode 会从带宽受限转为计算受限。GLM-5 的 MLA-256 就是针对这一点:把每头维度从 192 增大到 256,同时把头数减少 \(1/3\),保持训练计算量和参数量不变,降低 decode 计算量。GLM-5 还发现 Muon 优化器对 \(\mathbf{W}^{UQ},\mathbf{W}^{UK},\mathbf{W}^{UV}\) 做整体正交化会限制各头独立缩放,提出按头切分后分别正交化(Muon Split)。
采用情况. MLA 被 DeepSeek-V2/V3/R1/V3.2、Kimi K2/K2.5、GLM-5 采用,Kimi Linear 的全注意力层也是 MLA。
6.6 小结与遗留问题
方向 C 把每个 token 的 cache 缩小了一到两个数量级,但两件事没有改变:
- KV cache 仍然随 \(N\) 线性增长:DeepSeek-V3 在 1M 上下文时仍需约 69 GiB/序列(第 3.2 节的表);
- prefill 计算仍是 \(O(N^2)\);MLA 的 decode 计算甚至比 GQA 更重。
要降低随 \(N\) 增长的部分,必须减少 query 读取的KV 条目数量 \(|\mathcal{J}_t|\)(方向 D、E)或KV 条目总数(方向 F、G)。
7 方向 D:静态稀疏与局部-全局交错注意力
静态稀疏用一个与内容无关的固定模式定义可见集合 \(\mathcal{V}_t\)(框架维度 ①)。它最简单,也是开源模型中最常见的长上下文手段之一。
7.1 滑动窗口注意力(SWA)
每个 query 只看最近 \(w\) 个 token:prefill 计算量从 \(O(N^2)\) 降为 \(O(Nw)\),KV cache 从 \(O(N)\) 降为 \(O(w)\),可以用大小为 \(w\) 的环形缓冲区实现(token \(s\) 写入槽位 \(s\bmod w\))。
信息仍然可以跨层传播到窗口之外:第 \(l\) 层位置 \(t\) 的表示依赖第 \(l-1\) 层位置 \(t-w+1,\dots,t\),因此 \(L\) 层 SWA 的理论感受野为 \(L(w-1)+1\)。Mistral-7B(\(w=4096\),\(L=32\))的理论感受野约 131K。但远处信息要经过多次“接力”压缩进残差流,有效感受野远小于理论值,精确检索(如 needle-in-a-haystack)能力会明显下降。
7.2 Attention sink:StreamingLLM 与可学习 sink logit
第 3.5 节说明模型会把多余的注意力权重放在开头几个 token 上。纯 SWA 一旦把这些 token 移出窗口,困惑度就会急剧上升。StreamingLLM [Xiao et al., 2023] 的修复方法是永久保留前 \(n_0\) 个 token(通常 \(n_0=4\)):
更直接的做法是给每个头加一个可学习 sink logit \(\varsigma_h\),即式 (2.9) 中的分母项,相当于加了一个 value 为 \(\mathbf{0}\) 的虚拟 key。设普通 key 上的 log-sum-exp 为 \(\operatorname{LSE}_{t,h}=\ln\sum_{s\in\mathcal{V}_t}e^{\ell_{t,s,h}}\),原始 softmax 输出为 \(\mathbf{o}^{\text{std}}_{t,h}\)。由 LSE 合并公式 (4.3),带 sink 的输出为
式 (7.3) 说明:可学习 sink 等价于一个由“匹配强度”\(\operatorname{LSE}\) 决定的标量输出门。没有 key 匹配时(\(\operatorname{LSE}\ll\varsigma_h\)),头的输出接近零,不再需要借用某个真实 token 当“垃圾桶”,SWA 的窗口可以任意滑动。gpt-oss、MiMo-V2-Flash、DeepSeek-V4(CSA/HCA)都使用可学习 sink。第 11.3 节的 output gate 可以看作把这个标量门推广为与输入相关的逐元素门。
7.3 Chunked attention
另一种静态模式是把序列切成长度为 \(B\) 的不重叠块,每个 query 只看本块内、自己之前的 token:
它与 SWA 的区别是:块首 token 几乎看不到上下文,块尾 token 看到 \(B-1\) 个;优点是块与块之间完全独立,prefill 易于并行,cache 在块边界可以直接清空。Llama 4 的局部层使用 \(B=8192\) 的 chunked attention(第 5.6 节)。
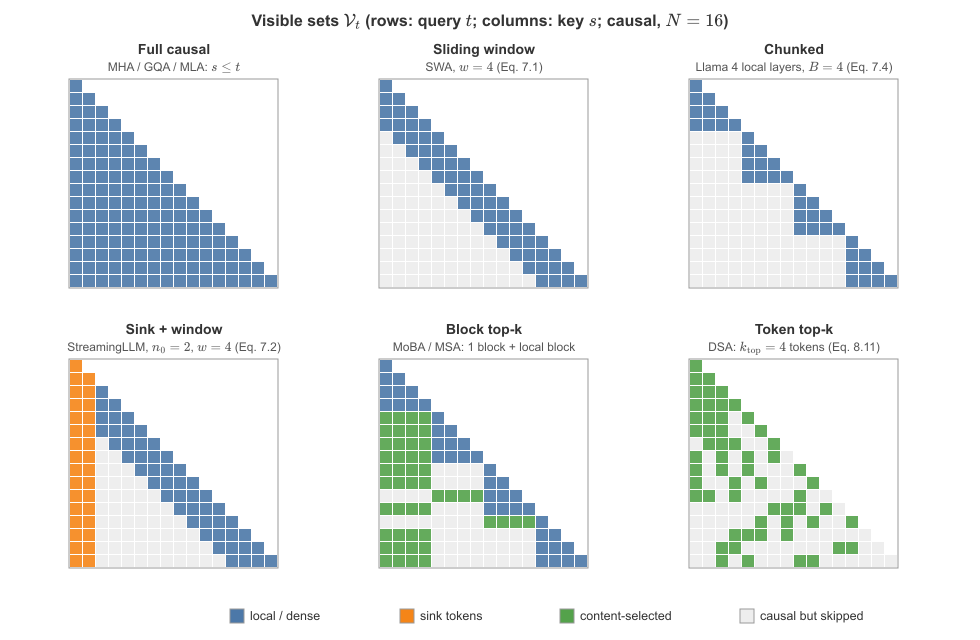
图 8. 六种注意力模式的可见集合 \(\mathcal{V}_t\):完整因果、滑动窗口(式 7.1)、chunked(式 7.4)、sink + 窗口(式 7.2)、块级 top-k(MoBA/MSA,式 8.4、8.13)、token 级 top-k(DSA,式 8.11)。
7.4 局部-全局交错层
纯局部注意力无法做远程检索,于是开源模型普遍把局部层与少量全局层交错排列。设每 \(r\) 个局部层配 1 个全局层,局部层窗口为 \(w\),每个KV 条目大小为 \(\varepsilon\) 字节,则 KV cache 为
\(N\gg w\) 时比值趋近 \(1/(r+1)\)。计算量同理。代表配置:
| 模型 | 局部类型 | 局部 : 全局 | 窗口 \(w\) / 块 \(B\) | 其他 |
|---|---|---|---|---|
| Mistral-7B | SWA | 全部 SWA | 4096 | 无全局层 |
| Gemma 2 | SWA | 1 : 1 | 4096 | logit soft-capping |
| Gemma 3 | SWA | 5 : 1 | 1024 | 局部 base \(10^4\),全局 base \(10^6\);128K |
| gpt-oss-120b/20b | banded SWA | 1 : 1 | 128 | 可学习 sink;GQA-8 |
| Llama 4 Scout/Maverick | chunked | 3 : 1 | 8192 | 全局层 NoPE + 温度(式 5.13) |
| MiMo-V2-Flash | SWA | 5 : 1 | 128 | 可学习 sink;KV cache 约减 6 倍 |
以 Gemma 3 为例(4B/12B/27B 支持 128K,1B 为 32K),\(N=128\text{K}\) 时由式 (7.5),\(\tfrac16+\tfrac56\cdot\tfrac{1024}{131072}\approx 0.173\),KV cache 约为全注意力的 \(1/5.8\)。Gemma 3 报告显示,把局部:全局从 1:1 提高到 5:1、窗口从 4096 缩到 1024,对困惑度的影响很小。
7.5 其他静态模式
早期的 Longformer、BigBird 在窗口之外加入膨胀(dilated)窗口、少量全局 token 和随机连接。LongLoRA 的 S²-Attn 在微调阶段把序列分组、一半头平移半组,用于低成本扩展上下文,推理时仍用全注意力。这些模式在当前主流开源 LLM 中已很少使用。
7.6 小结与遗留问题
静态稀疏把计算和 cache 都降到了 \(O(w)\) 量级,但远程信息只能依靠少数全局层。全局层仍是 \(O(N^2)\) 计算和 \(O(N)\) cache,局部层对远程检索没有直接贡献。GLM-5 在 GLM-9B 上的消融(RULER@128K)很说明问题:
| 方法 | RULER@128K |
|---|---|
| 全注意力 | 75.28 |
| SWA 交错(规则排列) | 44.93 |
| SWA 模式(搜索得到的层排列) | 69.59 |
| GDN 混合 | 64.00 |
| DSA(动态稀疏) | ≈ 75 |
固定模式无法知道“针”在哪里。要在稀疏的同时保留任意位置的检索能力,可见集合 \(\mathcal{J}_t\) 必须依赖内容,这就是方向 E。
8 方向 E:内容相关的动态稀疏注意力
动态稀疏的出发点是一个经验事实:长上下文中,softmax 注意力高度集中,每个 query 的绝大部分权重落在少数 key 上。如果能以较低成本预测这些 key 的位置,就可以只对它们做精确的 softmax。所有动态稀疏方法都是两阶段结构:
其中 \(I_{t,j}\) 是索引分数,\(\mathcal{J}^{\text{fixed}}_t\) 是总被保留的条目(当前块、局部窗口、sink 等)。各方法的差别在于:选择粒度(token 还是块)、打分函数 \(I_{t,j}\) 怎么算、选择在哪个层级共享(每头、每 GQA 组、全部头),以及如何训练不可导的 TopK。
在稀疏注意力内部,softmax 只在 \(\mathcal{J}_t\) 上归一化。设被丢弃的条目集合为 \(\bar{\mathcal{J}}_t\),由式 (4.3),稀疏输出与稠密输出的误差满足
其中 \(a^{\text{dense}}\) 为稠密注意力权重,\(\mathbf{o}^{\mathcal{J}},\mathbf{o}^{\bar{\mathcal{J}}}\) 分别为只在 \(\mathcal{J}_t\)、\(\bar{\mathcal{J}}_t\) 上归一化的局部输出。也就是说,误差由被丢弃的注意力质量 \(\varepsilon_t\) 控制。好的索引器应使选中集合覆盖尽可能多的注意力质量,这正是后文 KL 训练目标的来源。
8.1 块稀疏注意力:MoBA
MoBA(Mixture of Block Attention)[Lu et al., 2025, Moonshot AI] 把 MoE 的路由思想用于 KV 块。把序列按块长 \(B\) 切块 \(\mathcal{G}_j=\{(j-1)B+1,\dots,jB\}\),块的代表 key 取均值:
设 query \(t\) 所在块为 \(j_t=\lceil t/B\rceil\)。每个头在已完整结束的历史块中选 top-\(k_{\text{top}}\),再强制加入当前块(当前块内用因果掩码):
每个 query 读取约 \((k_{\text{top}}+1)B\) 个 token。MoBA 论文在 1M 上下文中取 \(B=4096\)、共选 12 块(含当前块),稀疏度约 \(1-\tfrac{12\times4096}{2^{20}}\approx 95\%\)。MoBA 无需新参数,可以和全注意力在层间或训练阶段之间切换;Kimi 用它支撑长上下文服务。缺点是均值池化的块表示比较粗糙,选择与主注意力共享同一组 \(\mathbf{q},\mathbf{k}\)。
8.2 NSA:压缩、选择与窗口三分支
NSA(Native Sparse Attention)[Yuan et al., 2025, DeepSeek] 把可见集合拆成三个互补分支,用输入相关的门融合:
① 压缩分支(cmp). 以块长 \(l\)、步长 \(\delta\)(\(\delta\le l\),允许重叠)滑动,用带块内位置编码的可学习映射 \(\varphi\) 把每段 key/value 压成一个条目:
query 对全部约 \(t/\delta\) 个压缩条目做稠密注意力,获得粗粒度的全局视野。
② 选择分支(slc). 选择块的打分直接复用压缩分支的注意力权重,不需要额外的索引器。设 \(\mathbf{p}^{\text{cmp}}_{t,h}=\operatorname{softmax}\big(\mathbf{q}_{t,h}^\top\tilde{\mathbf{K}}^{\text{cmp}}_t/\sqrt{d_h}\big)\)。选择块长为 \(l'\)(\(l'\) 是 \(\delta\) 的整数倍),选择块 \(j\) 的分数是与它重叠的所有压缩条目的权重之和;再在同一 GQA 组内求和,使组内所有头共享同一个选择:
被选中块内的原始 token 参与精确注意力。
③ 窗口分支(win). 最近 \(w\) 个 token 的原始 KV,即式 (7.1)。窗口分支单独处理局部模式,防止局部信号主导前两个分支的学习。
NSA 论文的配置为 \(l=32,\ \delta=16,\ l'=64,\ n=16\)(其中包含 1 个初始块和 2 个局部块),\(w=512\)。每个 query 读取的条目数约为
压缩分支仍然随 \(t\) 线性增长,只是常数缩小了 \(\delta\) 倍。NSA 的两个关键工程设计影响了后续所有方法:(i) 组内共享选择——同一 GQA 组的 \(g\) 个头加载同一组 KV 块,一次读入 SRAM 服务所有头,否则每个头不同的选择会让 IO 节省消失;(ii) 原生可训练——压缩分支可导,选择分支的打分来自压缩分支,模型从预训练开始就使用稀疏注意力,而不是推理时才加上。
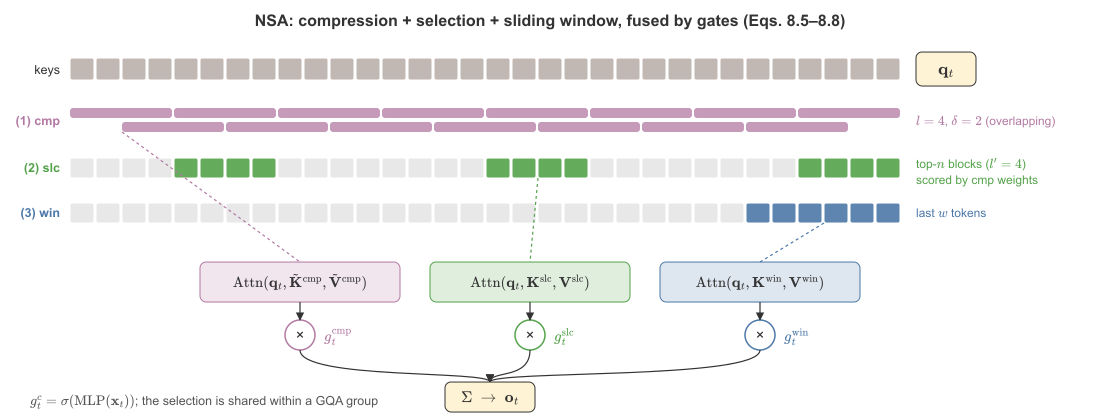
图 9. NSA(第 8.2 节):对重叠块的压缩分支、块分数来自压缩分支注意力权重的选择分支,以及滑动窗口分支,三者由输入相关的门融合(式 8.5)。
8.3 DSA:Lightning Indexer 与 token 级选择
DSA(DeepSeek Sparse Attention)[DeepSeek-AI, 2025, V3.2] 把选择粒度从块降到单个 token,并用一个独立的轻量索引器打分。
Lightning Indexer. 索引器有 \(H_I\) 个 query 头和一个所有头共享的 key 头(MQA 风格):
其中 \(\mathbf{c}^Q_t\) 是 MLA 的 query 潜变量(与主注意力共享,见第 6.2 节)。\(\mathbf{q}^I,\mathbf{k}^I\) 的一半维度施加 RoPE,经 Hadamard 旋转后量化为 FP8。DeepSeek-V3.2 中 \(H_I=64,\ d_I=128,\ k_{\text{top}}=2048\)。几个设计的理由:
- ReLU 而非 softmax:分数只用于排序,不需要归一化;ReLU 截掉负相关,逐元素计算,便于融合进 FP8 kernel。
- 输入相关的头权重 \(w^I_{t,j}\):让不同索引头的重要性随 query 变化。
- 单 key 头 + FP8:索引器 cache 每 token 只有 \(d_I=128\) 字节,是 MLA cache(576 个 BF16 元素,1152 字节)的约 11%。
- Hadamard 旋转:把离群通道的能量分散到所有维度,降低 FP8 量化误差。
主注意力. 选出的集合 \(\mathcal{S}_t=\operatorname{TopK}_s(I_{t,s},k_{\text{top}})\) 在所有头之间共享,主注意力用 MLA 的吸收形式(MQA 模式,第 6.3 节)在 \(\mathcal{S}_t\) 上计算:
由于 MLA 在 decode 时所有头共享同一份 KV,token 级选择不会带来 NSA 担心的“每头加载不同块”问题,这是 DSA 能用 token 粒度的结构性原因。
复杂度. 主注意力从 \(O(N^2)\) 降为 \(O(Nk_{\text{top}})\);索引器仍是 \(O(N^2)\),但每个 key 的代价约为 \(H_Id_I=8192\) 次 FP8 乘加,而 MLA 在 MQA 模式下约为 \(H(2d_c+d_R)\approx 1.4\times10^5\) 次 BF16 乘加(约 17 倍),加上 FP8 的吞吐优势,索引器约便宜一个数量级以上。decode 每步的 HBM 读取量为
\(N\gg k_{\text{top}}\) 时读取量约为原来的 \(128/1152\approx 1/9\)。但 KV cache 的存储量没有减少:所有 token 的 MLA cache 都要保留,以备未来被选中。
8.4 MSA:基于 GQA 的块稀疏注意力
MSA(MiniMax Sparse Attention)[Lai et al., 2026] 是 MiniMax-M3 的注意力,设计原则是“只保留必要组件”,以便直接复用 GQA 的软硬件栈。它在 GQA(第 6.1 节)上加一个极轻的索引分支:
- 索引分支:每个 GQA 组 \(\pi\) 一个索引 query \(\mathbf{q}^{I}_{t,\pi}\),所有组共享一个索引 key 头 \(\mathbf{k}^{I}_s\)。token 级分数经块内最大池化得到块级分数,每个 GQA 组独立选 top-\(k_{\text{top}}\) 个块,并强制保留最近的局部块:
- 主分支:组 \(\pi\) 内的 \(g\) 个 query 头在原始 GQA key/value 的选中块上做精确的块稀疏 softmax 注意力。
与 DSA 相比,MSA 选择块而非 token(适合 GQA 的块状访存与 tensor core),每个 GQA 组独立选择(比全部头共享更灵活),并用 max 池化(只要块中有一个 token 强匹配就选中,适合“找针”)。与 NSA 相比,MSA 去掉了压缩分支、窗口分支和门控,只保留“选择 + 局部块”。工程上,max 池化后的 top-k 不需要先做 softmax(exp-free Top-k),主分支按“KV 块在外层循环、收集所有选中该块的 query”的顺序组织,以提高 tensor core 利用率。论文报告:在 109B 参数的多模态模型上,MSA 与 GQA 性能相当,1M 上下文下每 token 注意力计算减少 28.4 倍,H800 上 prefill 与 decode 的实测加速分别为 14.2 倍与 7.6 倍。
MiniMax 的路线变化本身很有代表性:MiniMax-01/M1 使用 Lightning Attention(线性)与 softmax 的 7:1 混合;M2 回到全注意力,官方解释是高效注意力在多跳推理等复杂任务上还“不够生产可用”;M3 再转向 MSA。这说明在工业规模上,保留精确 softmax、只做稀疏选择的路线目前更受信任。
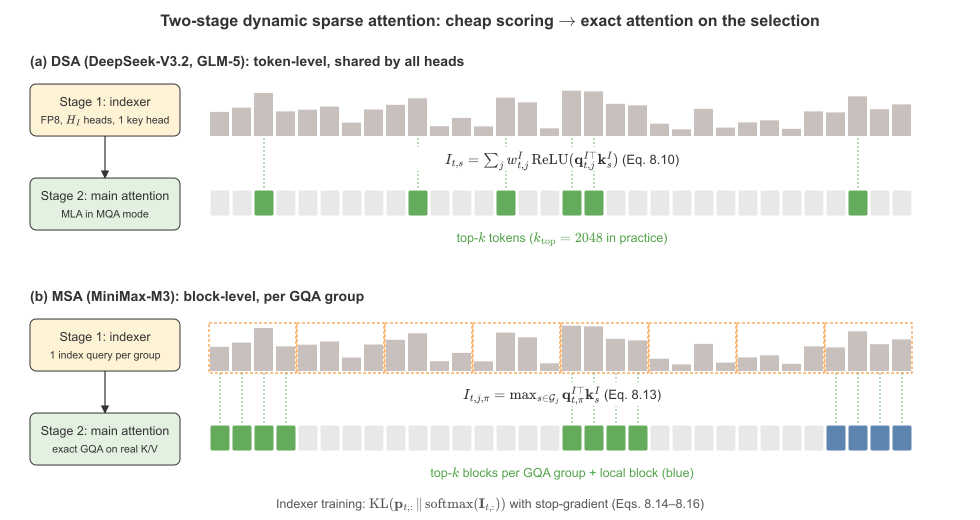
图 10. 两阶段动态稀疏注意力。(a) DSA 用廉价的 FP8 Lightning Indexer 给每个 token 打分,选出所有头共享的 top-k token;(b) MSA 把 token 分数按块做 max 池化,每个 GQA 组选出 top-k 块并加上局部块。
8.5 三种设计的对比
| MoBA | NSA | DSA | MSA | |
|---|---|---|---|---|
| KV 底座 | MHA/GQA | GQA | MLA | GQA |
| 选择粒度 | 块 | 块 | token | 块 |
| 打分来源 | 主 \(\mathbf{q}\) 与块均值 key | 压缩分支的注意力权重 | 独立 Lightning Indexer | 独立索引分支 + 块内 max |
| 选择共享范围 | 每头 | 每 GQA 组 | 全部头 | 每 GQA 组 |
| 固定保留 | 当前块 | 初始块 + 局部块 + 窗口 | 无(V3.2) | 局部块 |
| 额外分支 | 无 | 压缩 + 窗口 + 门控 | 无 | 无 |
| 选择器训练 | 无参数 | 端到端 | KL 蒸馏 + 梯度分离 | KL 蒸馏 + 梯度分离 |
| 代表模型 | Kimi 服务 | (研究) | DeepSeek-V3.2,GLM-5 | MiniMax-M3 |
8.6 训练不可导的选择器
TopK 对分数不可导,主注意力的语言模型损失无法直接训练索引器。DSA 与 MSA 都用注意力蒸馏来训练选择器。
目标分布. 把主注意力在所有头(DSA)或组内所有头(MSA)上的权重平均,得到目标分布:
阶段一:稠密 warmup. 冻结主模型,主注意力仍是稠密的,只训练索引器:
梯度形式说明:索引器的分数分布被推向主注意力的分布。由式 (8.2),这等价于让 top-k 覆盖尽可能多的注意力质量。DeepSeek-V3.2 的 warmup 为 1000 步、约 2.1B tokens,学习率 \(10^{-3}\);GLM-5 也是 1000 步,序列长度约 200K。
阶段二:稀疏训练. 主注意力切换为稀疏模式,KL 只在选中集合 \(\mathcal{S}_t\) 上计算(\(\mathbf{p}\) 在 \(\mathcal{S}_t\) 上重新归一化):
此时索引器的输入被 detach:索引器只接收 \(\mathcal{L}_I\) 的梯度,主模型只接收语言模型损失的梯度,避免索引器的学习信号干扰主模型。DeepSeek-V3.2 的稀疏训练约 944B tokens;GLM-5 只用了约 20B tokens,说明 DSA 可以较低成本地加到已有的 MLA 模型上。
RL 中的一致性. GLM-5 报告了两个实践要点:(i) 非确定性的 CUDA top-k 会使训练与推理选出不同集合,几步之内就导致性能骤降和熵崩溃,必须使用确定性 top-k;(ii) RL 阶段冻结索引器参数。这与 MoE 中的 routing replay 是同一类问题,但 \(k_{\text{top}}=2048\) 远大于 MoE 的专家数,无法像 MoE 一样直接存储并重放选择结果。
8.7 小结与遗留问题
动态稀疏在 128K–200K 量级上做到了近乎无损(GLM-5 的 RULER 消融),但还有两个不足:
- 存储不减:DSA/MSA 只减少每步读取的 KV,KV cache 仍是 \(O(N)\)。1M 上下文时,DeepSeek-V3.2 每条序列需要约 69 GiB(MLA)加约 7.6 GiB(索引器)的 cache。
- 索引器是 \(O(N^2)\):它便宜,但在 1M 量级上仍不可忽略,而且索引器本身也需要 \(O(N)\) 的 cache。
如果要同时降低存储、索引成本和注意力计算,就需要减少KV 条目的总数,也就是沿序列维度压缩,这是方向 F。
9 方向 F:序列维 KV 压缩——DeepSeek-V4 的 CSA 与 HCA
方向 C 压缩每个KV 条目的宽度,方向 F 压缩KV 条目的数量(框架维度 ③):每 \(m\) 个连续 token 压成 1 个条目,cache 与所有对 cache 的计算都缩小到 \(1/m\)。NSA 的压缩分支(式 8.6)是这一思想的雏形,DeepSeek-V4 [DeepSeek-AI, 2026] 把它变成了主要的注意力形式。V4 包括 V4-Pro(1.6T 总参数 / 49B 激活)与 V4-Flash(284B / 13B),原生上下文 1M。
本节符号与 V4 原文的对应:原文的压缩率 \(m\)(CSA)与 \(m'\)(HCA)沿用;原文的KV 条目维度 \(c\) 记为 \(d_e\);原文的 top-k 记为 \(k_{\text{top}}\);原文的输出投影组数 \(G\) 记为 \(n_{\text{grp}}\)。V4-Pro 的配置为
V4-Flash 中 \(d=4096,\ L=43,\ H=64,\ d_q=1024,\ k_{\text{top}}=512\)。
9.1 共享 key-value 的 KV 条目
V4 的每个KV 条目是一个 \(d_e\) 维向量 \(\mathbf{e}_u\),同时充当 key 和 value(shared-KV MQA):
与 MLA 吸收后的形式(式 6.4–6.5,key 与 value 都是 \(\mathbf{c}^{KV}_s\))相比,这里把“共享”做成了显式设计,cache 中每个条目只存一份 \(\mathbf{e}_u\)。query 由低秩路径生成:\(\mathbf{c}^Q_t=\mathbf{W}^{DQ}\mathbf{x}_t\in\mathbb{R}^{d_q}\),\(\mathbf{q}_{t,h}=\mathbf{W}^{UQ}_h\mathbf{c}^Q_t\in\mathbb{R}^{d_e}\);\(\mathbf{c}^Q_t\) 同时供索引器使用。\(\mathbf{q}_{t,h}\) 与 \(\mathbf{e}_u\) 在进入注意力之前都经过 RMSNorm,防止 logit 爆炸(第 12 节)。
9.2 CSA:重叠压缩(overlapped compression)+ 稀疏选择
重叠压缩. 每个 token 产生两组候选向量和两组压缩打分(\(\mathbf{W}\in\mathbb{R}^{d_e\times d}\)):
令第 \(j\) 个块为 \(\mathcal{G}_j=\{(j-1)m+1,\dots,jm\}\),记 \(\operatorname{pos}(s)\in\{1,\dots,m\}\) 为 token \(s\) 在块内的位置。第 \(j\) 个压缩条目由当前块(用 \(a\) 组)和前一块(用 \(b\) 组)共 \(2m\) 个 token 生成。对每个通道 \(r=1,\dots,d_e\),在这 \(2m\) 个 token 上做 softmax:
其中 \(\mathbf{B}^a,\mathbf{B}^b\in\mathbb{R}^{m\times d_e}\) 是可学习的块内位置偏置;\(j=1\) 时前一块的打分填 \(-\infty\)、向量填 \(\mathbf{0}\)。几点说明:
- 逐通道加权:\(\odot\) 意味着每个通道独立决定哪个 token 贡献最大,比标量加权表达力强。这是一种“通道级 softmax 池化”,介于均值池化(MoBA)和 MLP(NSA)之间。
- 重叠:每个 token 通过 \(a\) 组“主导”自己所在块的条目,又通过 \(b\) 组“辅助”下一个块的条目。相邻条目共享边界信息,避免硬切分导致的语义断裂;但条目总数仍为 \(\lceil t/m\rceil\),压缩率仍是 \(1/m\)。
- 因果性:\(\tilde{\mathbf{e}}_j\) 融合了块 \(j\) 内全部 token,因此只有当整个块都在 query 之前时才可用:
稀疏选择. 索引器 key 用同样的重叠压缩得到 \(\tilde{\mathbf{k}}^{I}_j\in\mathbb{R}^{d_I}\),打分沿用 Lightning Indexer 的形式(式 8.10),只是对象从 token 换成了压缩条目:
滑动窗口分支. 压缩路径有两个缺口:(i) 由式 (9.5),query 所在的未完成块(最多 \(m-1\) 个 token)完全不可达;(ii) 最近的局部上下文需要逐 token 的精确表示。因此每层还保留最近 \(w\) 个 token 的未压缩条目 \(\mathbf{e}^{\text{win}}_s=\mathbf{W}^{KV}\mathbf{x}_s\in\mathbb{R}^{d_e}\)。它们与压缩条目维度相同,放进同一个 softmax(式 4.3 的直接应用)。CSA 的最终可读集合为
再加上式 (9.1) 中的 sink。V4-Pro 中 \(|\mathcal{J}_t|\le1024+128=1152\),V4-Flash 中 \(\le512+128=640\)。
9.3 HCA:重度压缩 + 稠密注意力
HCA 使用大得多的压缩率 \(m'=128\)、不重叠的单组压缩:
其中 \(\mathcal{G}'_j\) 是长度为 \(m'\) 的块。压缩后的条目很少(1M 上下文约 \(2^{20}/128=8192\) 个),因此 HCA 不做选择,直接对所有已完成的压缩条目做稠密注意力,同样加上窗口分支与 sink:
CSA 保留较细的粒度并用稀疏选择找到相关位置,HCA 用极粗的粒度保证对全局的稠密覆盖,两者互补。V4-Pro 的前 2 层为 HCA,之后 CSA 与 HCA 逐层交替;V4-Flash 的前 2 层为纯滑动窗口注意力。

图 11. DeepSeek-V4 的 CSA 与 HCA(第 9 节)。CSA 用重叠的逐通道 softmax 池化把每 \(m=4\) 个 token 压成一个条目,用索引器选出 top-k 条目,与未压缩的窗口和 sink 一起放进同一个 softmax;HCA 把每 \(m'=128\) 个 token 不重叠地压缩,并做稠密注意力。
9.4 共享 key-value 条目下的 RoPE:输出端反向旋转
V4 只对 query 和KV 条目的最后 \(d_R=64\) 维施加 RoPE。由于 \(\mathbf{e}_u\) 同时是 value,注意力输出中的这 64 维会带上绝对位置。设条目 \(u\) 的位置为 \(p_u\),把这部分写成 \(\mathbf{R}_{p_u}\mathbf{e}^{R}_u\),则
V4 对输出的这 64 维再施加一次位置为 \(-t\) 的旋转:
于是输出只依赖相对位置 \(p_u-t\)。这里用到了 \(\mathbf{R}_{-t}\mathbf{R}_{p}=\mathbf{R}_{p-t}\) 和旋转的线性性。式 (9.12) 是“key 与 value 共享”这一设计带来的特有问题和解决方法,在 MLA 中不出现(MLA 的 value 不带 RoPE 分量)。
9.5 分组输出投影
\(H=128\)、\(d_e=512\) 时,直接把 \([\mathbf{o}_{t,1};\dots;\mathbf{o}_{t,H}]\in\mathbb{R}^{Hd_e}\) 投影回 \(d\) 维需要 \(Hd_ed\approx 4.7\times10^8\) 个参数(每层)。V4 把 \(H\) 个头分成 \(n_{\text{grp}}\) 组,先组内投影到 \(d_G\) 维,再整体投影:
V4-Pro 中 \(n_{\text{grp}}=16,\ d_G=1024\),参数量为 \(Hd_ed_G+n_{\text{grp}}d_Gd\approx 6.7\times10^7+1.17\times10^8=1.84\times10^8\),约为直接投影的 39%。
9.6 代价分析
以 \(N=1\text{M}\) 为例,每层每个 query 的读取量与每 token 的 cache:
| 主注意力读取条目数 | 索引器打分对象数 | 每 token 每层 cache(元素) | |
|---|---|---|---|
| V3.2(MLA + DSA) | \(k_{\text{top}}=2048\) | \(N\approx 10^6\) | \(576+128\)(索引器) |
| V4 CSA(\(m=4\)) | \(k_{\text{top}}+w=1152\) | \(N/m\approx 2.6\times10^5\) | \(d_e/m+d_I/m=128+32\) |
| V4 HCA(\(m'=128\)) | \(N/m'+w\approx 8320\) | 无 | \(d_e/m'=4\) |
上表 cache 列忽略了滑动窗口的固定 \(w\,d_e\) 部分(与 \(N\) 无关)。按 CSA/HCA 各占一半粗略估算,V4 每 token 每层平均约 \((160+4)/2=82\) 个元素,约为 V3.2 的 \(82/704\approx 12\%\);再考虑 V4 对非 RoPE 维度使用 FP8 存储,与技术报告给出的“1M 上下文下 KV cache 约为 V3.2 的 10%(Pro)/7%(Flash),单 token 推理 FLOPs 约为 27%(Pro)/10%(Flash)”一致(这是我们的估算,不是报告中的分解)。V4 的索引器 QK 计算使用 FP4。
9.7 小结与遗留问题
CSA/HCA 是目前开源模型中把 softmax 注意力推到 1M 的最激进方案:
总读取比例在 V4-Pro CSA 层约为 \(1152/2^{20}\approx 0.11\%\)。但它仍然保留了一个随 \(N\) 增长的 cache(只是常数缩小了 \(m\) 或 \(m'\) 倍),HCA 层的稠密注意力与 CSA 的索引器仍然随 \(N\) 增长。如果要求每层记忆完全不随 \(N\) 增长,就必须放弃“为每个(或每组)token 保留一个条目”,改为把全部历史写入一个固定大小的状态,这就是方向 G。
10 方向 G:线性注意力与固定大小记忆
10.1 从 softmax 到核:线性注意力
把式 (2.2) 中的 \(\exp(\mathbf{q}^\top\mathbf{k}/\sqrt{d_h})\) 换成一个可分解的核 \(\kappa(\mathbf{q},\mathbf{k})=\phi(\mathbf{q})^\top\phi(\mathbf{k})\) [Katharopoulos et al., 2020]。为简化记号,下文把特征映射 \(\phi\) 吸收进 query/key 的生成过程,仍记作 \(\mathbf{q}_t,\mathbf{k}_s\in\mathbb{R}^{d_k}\)(\(d_k=d_h\)),并省略头下标 \(h\):
第一个等号到第二个等号只是把与 \(s\) 无关的 \(\mathbf{q}_t\) 移出求和,这在 softmax 下做不到,因为 softmax 的逐行归一化不是双线性的。由此得到:
- 训练:总计算量 \(O(Nd_kd_v)\),关于 \(N\) 线性;
- 推理:每步只更新并读取 \(\mathbf{S}_t,\mathbf{z}_t\),单步计算 \(O(d_kd_v)\)、状态 \(O(d_kd_v)\),都与 \(N\) 无关。
用第 2.4 节的框架看,线性注意力的“记忆”就是一个 \(d_k\times d_v\) 的关联矩阵:\(\mathbf{k}_t\) 是写地址,\(\mathbf{v}_t\) 是写内容,\(\mathbf{q}_t\) 是读地址。现代变体通常去掉分母 \(\mathbf{z}_t^\top\mathbf{q}_t\)(数值不稳定),改为对输出做 RMSNorm 或 GroupNorm;下文统一写作
10.2 固定记忆的根本限制:容量与串扰
设历史上写入了 \(n\) 对 \((\mathbf{k}_s,\mathbf{v}_s)\),用第 \(j\) 个 key 作为 query 检索(\(\mathbf{q}=\mathbf{k}_j\)):
若所有 key 两两正交,串扰为零,但 \(\mathbb{R}^{d_k}\) 中最多只有 \(d_k\) 个正交向量。若 key 是随机单位向量,\(\mathbf{k}_s^\top\mathbf{k}_j\) 的方差约为 \(1/d_k\),串扰项的方差约为 \((n-1)\,\mathbb{E}\|\mathbf{v}\|^2/d_k\),信噪比
因此 \(n\gg d_k\) 时无法精确检索。这是所有固定状态模型的共同上限:一个 \(d_k\times d_v\) 的状态,最多可靠地存储 \(O(d_k)\) 条关联。而 softmax 注意力的 KV cache 随 \(n\) 增长,加上 \(\exp\) 对最大匹配的放大作用(式 3.4),可以从任意多条记录中检索出一条。
式 (10.4)–(10.5) 给出了后续演进的两条线索:
- 纯累加的 \(\mathbf{S}_t\) 会被过时信息塞满,需要遗忘(10.3 节);
- 同一个 key 反复写入会叠加而不是覆盖,需要按地址修正(10.4 节)。
10.3 遗忘门:从固定衰减到数据相关衰减
在写入前给旧状态乘上一个衰减:
\(\mathbf{A}_t\) 的不同选择对应不同模型:
| 模型 | \(\mathbf{A}_t\) | 衰减粒度 |
|---|---|---|
| 线性注意力 | \(\mathbf{I}\) | 无遗忘 |
| RetNet / Lightning Attention(MiniMax-01) | \(\gamma\,\mathbf{I}\),\(\gamma\) 为每头固定常数 | 头级、与数据无关 |
| Mamba-2 | \(\alpha_t\mathbf{I}\),\(\alpha_t\in(0,1]\) 由输入生成 | 头级、数据相关 |
| GLA | \(\operatorname{Diag}(\boldsymbol{\alpha}_t)\),\(\boldsymbol{\alpha}_t\in(0,1]^{d_k}\) | 通道级、数据相关 |
并行形式与衰减掩码. 对标量衰减,定义累积衰减 \(\gamma_t=\prod_{r\le t}\alpha_r\)。展开式 (10.6) 得
这就是 Mamba-2 的“状态空间对偶”(SSD)[Dao & Gu, 2024]:同一个模型既可以写成线性递推(推理用),也可以写成带衰减掩码的“注意力”(训练用)。\(\mathbf{D}\) 起到了与 RoPE 类似的近因偏置作用,这也是 Kimi Linear 敢于让全局 MLA 层使用 NoPE 的原因。
对通道级衰减,记 \(\mathbf{b}_t=\prod_{r\le t}\boldsymbol{\alpha}_r\in\mathbb{R}^{d_k}\)(逐元素累乘),有
其中 \(\oslash\) 为逐元素除法。实际 kernel 在块内计算相对累乘(或在对数空间计算),以避免 \(\mathbf{b}_s\) 下溢。
遗忘门解决了“状态被塞满”的问题,但它是无差别的:要清除一条过时的关联,只能把所有关联一起衰减。
10.4 Delta 规则:按地址覆盖
DeltaNet [Schlag et al., 2021; Yang et al., 2024b] 的思路是:写入前先读出当前 key 上已有的值 \(\hat{\mathbf{v}}_t=\mathbf{S}_{t-1}^\top\mathbf{k}_t\),只写入“误差”\(\mathbf{v}_t-\hat{\mathbf{v}}_t\):
在线回归解释. 对当前样本定义重建损失 \(\mathcal{L}_t(\mathbf{S})=\tfrac12\|\mathbf{S}^\top\mathbf{k}_t-\mathbf{v}_t\|^2\),其梯度为 \(\nabla_{\mathbf{S}}\mathcal{L}_t=\mathbf{k}_t(\mathbf{S}^\top\mathbf{k}_t-\mathbf{v}_t)^\top\)。式 (10.9) 正是从 \(\mathbf{S}_{t-1}\) 出发、学习率为 \(\beta_t\) 的一步梯度下降:
相比之下,纯累加 \(\mathbf{S}_t=\mathbf{S}_{t-1}+\mathbf{k}_t\mathbf{v}_t^\top\) 对应的是线性损失 \(-\mathbf{v}_t^\top\mathbf{S}^\top\mathbf{k}_t\) 的梯度步,它没有“已经存好就不再写”的饱和机制。因此线性注意力族可以统一看作在推理时对状态 \(\mathbf{S}\) 做在线学习,不同模型对应不同的损失与正则(Titans、TTT 等“测试时训练”模型把这个视角推广到 MLP 状态)。
覆盖性质. 设 \(\|\mathbf{k}_t\|_2=1\)(实现中对 key 做 L2 归一化),写入后在同一 key 上的读出为
\(\beta_t\to1\) 时精确覆盖。对任意其他读地址 \(\mathbf{q}\),变化量为 \(\beta_t(\mathbf{k}_t^\top\mathbf{q})(\mathbf{v}_t-\hat{\mathbf{v}}_t)\),与 \(\mathbf{k}_t\) 正交的方向不受影响。转移矩阵 \(\mathbf{I}-\beta_t\mathbf{k}_t\mathbf{k}_t^\top\) 是广义 Householder 矩阵,特征值为 \(1\)(\(d_k-1\) 重,对应与 \(\mathbf{k}_t\) 正交的子空间)和 \(1-\beta_t\)(对应 \(\mathbf{k}_t\) 方向)。
DeltaNet 只修改当前 key 方向;长期不再被访问的旧方向不会被清理,仍占用容量。
10.5 Gated DeltaNet:全局遗忘 + 定向修正
Gated DeltaNet(GDN) [Yang et al., 2025] 把 Mamba-2 的标量门与 Delta 规则结合:先衰减,再在衰减后的状态上做 Delta 修正。
推导:令 \(\bar{\mathbf{S}}=\alpha_t\mathbf{S}_{t-1}\),对 \(\bar{\mathbf{S}}\) 应用式 (10.9) 即得式 (10.12)。注意 \(\alpha_t\) 只乘在旧状态上,不乘新写入项。对任意读地址 \(\mathbf{q}\),
\(\alpha_t\) 很小时可以在上下文切换处快速清空整头记忆;\(\beta_t\) 负责精确编辑单条关联。Qwen3-Next 与 Qwen3.5 采用 GDN,参数化方式与 Mamba 类似:
其中 \(A\)、\(b_{\Delta}\) 是每头的可学习标量(具体形式以各模型的开源实现为准)。
10.6 Kimi Delta Attention(KDA):通道级遗忘
GDN 的 \(\alpha_t\) 是头级标量,一个头内所有 key 通道只能以同一速率遗忘。KDA [Kimi Team, 2025] 把它换成通道级向量门 \(\boldsymbol{\alpha}_t\in(0,1]^{d_k}\),并把对角门放在 Householder 矩阵右侧:
这可以分三步理解:(1) 选择性遗忘 \(\tilde{\mathbf{S}}=\operatorname{Diag}(\boldsymbol{\alpha}_t)\mathbf{S}_{t-1}\),第 \(i\) 行(第 \(i\) 个 key 通道)乘以 \(\alpha_{t,i}\),不同通道拥有不同的时间尺度;(2) 擦除 当前 key 方向的旧关联,\(\tilde{\mathbf{S}}-\beta_t\mathbf{k}_t(\tilde{\mathbf{S}}^\top\mathbf{k}_t)^\top\);(3) 写入 \(\beta_t\mathbf{k}_t\mathbf{v}_t^\top\)。由于一般有 \((\mathbf{I}-\beta\mathbf{k}\mathbf{k}^\top)\operatorname{Diag}(\boldsymbol{\alpha})\ne\operatorname{Diag}(\boldsymbol{\alpha})(\mathbf{I}-\beta\mathbf{k}\mathbf{k}^\top)\),门的位置会影响模型,KDA 的 chunkwise 算法是围绕式 (10.15) 的顺序设计的。
神经参数化(Kimi Linear). 对每个头:
其中 ShortConv 是核长很短(如 4)的因果深度卷积,给 q/k/v 提供廉价的局部 token 混合(例如 induction head 需要的“前一个 token”信息);\(\mathbf{W}^{\alpha}_{\downarrow},\mathbf{W}^{\alpha}_{\uparrow}\) 是低秩瓶颈;\(f\) 是把输出映射到 \((0,1]\) 的函数(与式 10.14 同类的 softplus–exp 形式)。q/k 的 L2 归一化保证 \(\|\mathbf{k}_t\|=1\),使式 (10.11) 成立并保证转移矩阵谱半径不超过 1。多头输出经逐头 RMSNorm 与输出门:
10.7 Chunkwise 并行训练
逐 token 递推适合推理,但训练时无法利用 tensor core。标准做法是把序列切成长度为 \(C\) 的块:块间递推传递状态,块内用矩阵乘法并行计算。
(a) 线性注意力. 记块 \([c]\) 内按行堆叠的矩阵为 \(\mathbf{Q}_{[c]},\mathbf{K}_{[c]}\in\mathbb{R}^{C\times d_k}\)、\(\mathbf{V}_{[c]}\in\mathbb{R}^{C\times d_v}\),块开始前的状态为 \(\mathbf{S}_{[c]}\)。由式 (10.3) 的行形式 \(\mathbf{o}_t^\top=\mathbf{q}_t^\top\mathbf{S}_t\):
其中 \(\mathbf{M}_C\) 是 \(C\times C\) 的下三角全 1 矩阵(含对角线)。总计算量为 \(O(NCd_k+Nd_kd_v)\)。\(C=1\) 退化为递推,\(C=N\) 退化为式 (10.7) 的并行形式,\(C\) 取 64–256 时最适合 GPU。MiniMax-01 的 Lightning Attention 就是带固定衰减的式 (10.18)。带标量衰减时,块内乘上式 (10.7) 的 \(\mathbf{D}\),块间项乘上块内累积衰减。
(b) Delta 规则:WY 表示与 UT 变换 [Yang et al., 2024b]. 在块内(下标 \(i=1,\dots,C\) 为块内位置,\(\mathbf{S}_0=\mathbf{S}_{[c]}\)),展开式 (10.9):
用归纳法可以证明,连续 Householder 型矩阵的乘积和 \(\mathbf{H}_i\) 都有紧凑的WY 表示:
(证明:\(\mathbf{P}_i=\mathbf{P}_{i-1}-\beta_i\mathbf{k}_i(\mathbf{P}_{i-1}^\top\mathbf{k}_i)^\top\),代入归纳假设即得 \(\mathbf{w}_i=\beta_i\mathbf{P}_{i-1}^\top\mathbf{k}_i\);\(\mathbf{u}_i\) 同理。)式 (10.21) 是下三角线性方程组。按行堆叠 \(\mathbf{W},\mathbf{U}\),记 \(\boldsymbol{\beta}=\operatorname{diag}(\beta_1,\dots,\beta_C)\),则
其中 \(\operatorname{tril}_{-1}\) 取严格下三角部分。这就是 UT 变换:一次 \(C\times C\) 的三角求逆,把 \(C\) 个串行的秩一更新变成矩阵乘法。把式 (10.20) 代入 \(\mathbf{S}_i\) 与 \(\mathbf{o}_i^\top=\mathbf{q}_i^\top\mathbf{S}_i\),得到与式 (10.18) 同构的块形式:
与式 (10.18) 相比,只是把 \(\mathbf{V}_{[c]}\) 换成了“扣除旧状态预测后的有效 value”\(\mathbf{U}-\mathbf{W}\mathbf{S}_{[c]}\)。
(c) 加入门控. 对 GDN(式 10.12),令块内累积衰减 \(\gamma_i=\prod_{r\le i}\alpha_r\),并做变量替换 \(\mathbf{S}_i=\gamma_i\mathbf{S}'_i\),代入得
即把 \(\mathbf{v}_i\) 换成 \(\mathbf{v}_i/\gamma_i\) 的普通 DeltaNet,因此可以直接套用式 (10.20)–(10.23)(实际 kernel 会把 \(\gamma\) 吸收进 \(\mathbf{T}\) 与块内掩码,以避免除以很小的数)。对 KDA(式 10.15),令 \(\mathbf{b}_i=\prod_{r\le i}\boldsymbol{\alpha}_r\)、\(\boldsymbol{\Gamma}_i=\operatorname{Diag}(\mathbf{b}_i)\),做替换 \(\mathbf{S}_i=\boldsymbol{\Gamma}_i\mathbf{S}'_i\):
推导中用到 \(\boldsymbol{\Gamma}_i^{-1}(\mathbf{I}-\beta\mathbf{k}\mathbf{k}^\top)\boldsymbol{\Gamma}_i=\mathbf{I}-\beta(\boldsymbol{\Gamma}_i^{-1}\mathbf{k})(\boldsymbol{\Gamma}_i\mathbf{k})^\top\)。式 (10.25) 是一个“写地址”\(\check{\mathbf{k}}\) 与“擦除读地址”\(\hat{\mathbf{k}}\) 不同的 Delta 规则,WY 递推相应改为 \(\mathbf{w}_i=\beta_i\big(\hat{\mathbf{k}}_i-\sum_{r<i}(\check{\mathbf{k}}_r^\top\hat{\mathbf{k}}_i)\mathbf{w}_r\big)\)。这说明 KDA 是对角加低秩(DPLR)转移矩阵的一个受约束特例:一般 DPLR 的转移为 \(\operatorname{Diag}(\boldsymbol{\alpha}_t)-\mathbf{a}_t\mathbf{b}_t^\top\),KDA 把 \(\mathbf{a}_t,\mathbf{b}_t\) 都绑定到 \(\mathbf{k}_t\),从而减少计算量并提高数值稳定性。
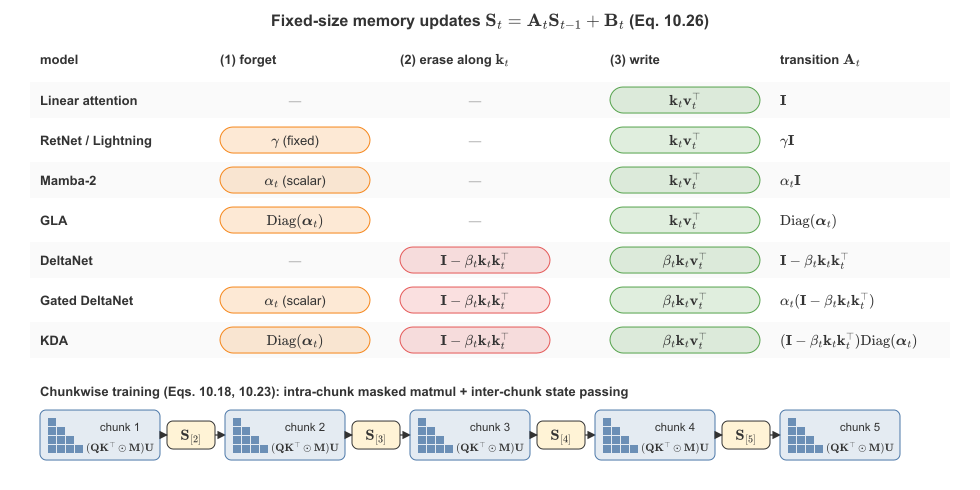
图 12. 线性注意力族在固定大小 \(d_k\times d_v\) 状态上的“遗忘、擦除、写入”操作(式 10.26),以及 chunkwise 训练方式(式 10.18、10.23)。
10.8 线性注意力族小结
所有模型都是 \(\mathbf{S}_t=\mathbf{A}_t\mathbf{S}_{t-1}+\mathbf{B}_t\) 的形式,转移矩阵从 \(\mathbf{I}\) 演进到“对角 × Householder”,表达力逐步提高,同时都保留 chunkwise 并行算法。但式 (10.5) 的容量上限对所有模型都成立:门控和 Delta 规则改善的是如何利用有限容量,而不是提高容量。在需要从大量记录中精确检索的任务上(多键 needle、长程多跳推理),纯线性模型仍不如 softmax 注意力。这引出了方向 H。
11 方向 H:混合架构
11.1 为什么要混合
各方向各有短板:线性层的记忆有损(式 10.5),全注意力层昂贵,局部层看不远。混合架构让大多数层承担低成本的序列建模,少数层负责精确的全局检索。设每 \(r\) 个“高效层”配 1 个全注意力层,高效层为固定状态的线性层(每层状态 \(\Sigma\) 字节,与 \(N\) 无关),全注意力层每 token 每层 cache 为 \(\varepsilon\) 字节,则
与式 (7.5) 比较:SWA 混合中高效层的 cache 是 \(w\varepsilon\),线性混合中是固定状态 \(\Sigma\),二者都与 \(N\) 无关。\(N\) 很大时,cache 和二次计算都约为全注意力模型的 \(1/(r+1)\)。注意这只是常数倍的改善:全注意力层仍保留 \(O(N^2)\) 与 \(O(N)\),因此混合架构也可以与 C、E、F 方向叠加(如 Kimi Linear 的全注意力层使用 MLA)。
理论上,有工作证明了“线性层 + 少量全注意力层”的表达能力层级严格介于纯线性与纯全注意力之间 [arXiv:2602.01763];实践中,3:1 左右的配比在多数基准上接近全注意力。
11.2 代表模型
| 模型 | 高效层 | 全局层 | 比例 | 上下文 |
|---|---|---|---|---|
| MiniMax-01 / M1 | Lightning Attention | softmax(GQA) | 7 : 1 | 1M 训练,推理 4M |
| Qwen3-Next / Qwen3.5 | Gated DeltaNet | Gated Attention(GQA) | 3 : 1 | 262K 原生,可扩展到约 1M |
| Kimi Linear | KDA | MLA(NoPE) | 3 : 1 | 1M |
| Jamba | Mamba | GQA | 7 : 1 | 256K |
| Gemma 3 | SWA(\(w=1024\)) | 全注意力 | 5 : 1 | 128K |
| MiMo-V2-Flash | SWA(\(w=128\))+ sink | 全注意力 | 5 : 1 | 256K |
| gpt-oss | SWA(\(w=128\))+ sink | 全注意力 | 1 : 1 | 128K |
| Llama 4 | chunked(\(B=8192\))RoPE | NoPE 全注意力 | 3 : 1 | 最高 10M(Scout) |
| DeepSeek-V4 | CSA | HCA | 逐层交替 | 1M |
可以看到,“混合”已经不是线性注意力专属的设计:SWA/全局交错、CSA/HCA 交错本质上也是混合。混合的轴有三种:层间(上表大部分)、层内头间(如 Hymba、Falcon-H1 在同一层并行放置注意力头和 SSM 头)、分支间(NSA 三分支、V4 的压缩 + 窗口)。
Kimi Linear 报告了一个有意义的结果:在相同训练配方下,KDA:MLA = 3:1 的混合模型在短上下文、长上下文和 RL 任务上都超过全 MLA 基线,同时 1M 上下文的 KV cache 减少约 75%、decode 吞吐提升最多约 6 倍。这说明在合适的配比下,线性层带来的近因偏置不仅是“省钱”,也可能是有益的归纳偏置。
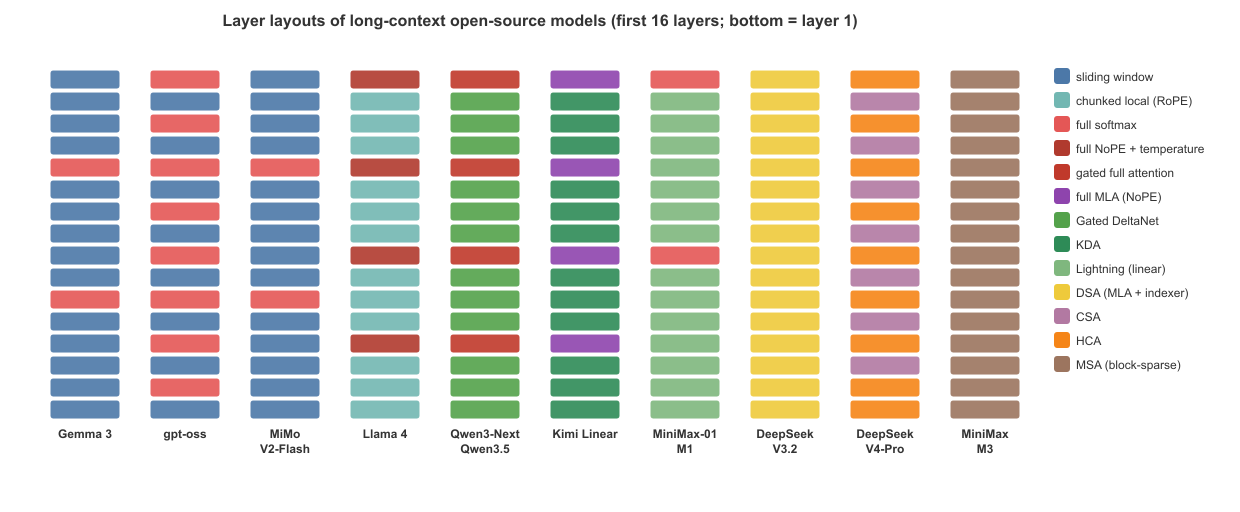
图 13. 长上下文开源模型的层排布(前 16 层):局部-全局交错、线性-全注意力混合,以及稀疏 / 压缩注意力(第 7.4、11.2、14.2 节)。DeepSeek-V4-Pro 前两层为 HCA,之后 CSA 与 HCA 交替。排布为示意,MiniMax-M3 按每层都是 MSA 绘制。
11.3 门控注意力(Gated Attention)
Qwen3-Next/Qwen3.5 的全注意力层不是标准 softmax,而是在注意力输出后加一个逐头、逐元素的 sigmoid 门 [Qiu et al., 2025]:
它带来三个效果:
- 打破低秩瓶颈:没有门时,\(\mathbf{W}^{O}_h\mathbf{o}_{t,h}=\sum_s a_{t,s,h}\mathbf{W}^{O}_h\mathbf{W}^{V}_h\mathbf{x}_s\),\(\mathbf{W}^{O}_h\mathbf{W}^{V}_h\) 是秩不超过 \(d_v\) 的线性映射;门在两者之间插入了一个依赖 query 的非线性。
- 稀疏化输出:训练后门值大多接近 0,头可以按 query 关闭。
- 消除 attention sink:与式 (7.3) 比较,
两者都让头可以“不输出”,因此模型不再需要在首 token 上堆积注意力。Qiu et al. 报告门控后首 token 的注意力占比从约 46.7% 降到约 4.8%,massive activation 消失,训练对大学习率更稳定,长度外推也更好。KDA 的输出门(式 10.17)是同一思想在线性层中的应用。
11.4 MiniMax 的经验:混合的工程风险
MiniMax-M2 在 M1 的 7:1 线性混合之后回到了全注意力。MiniMax 官方博客给出的理由主要是工程与评估层面的:(i) 在更大规模上,混合模型在多跳推理等复杂任务上出现退化,而公开基准不容易发现这些问题,需要专门构造代理指标;(ii) 推理栈(前缀缓存、投机解码、低精度 kernel)对线性注意力的支持还不成熟。之后的 M3 选择了保留精确 softmax 的块稀疏 MSA(第 8.4 节)。这与 GLM-5 的消融结论(DSA 近乎无损,GDN 混合在 RULER@128K 上掉约 11 分)一致:截至 2026 年,稀疏 softmax 与 线性混合 两条路线并存,前者在精确检索与工程兼容性上更占优,后者在固定状态与吞吐上更占优。
11.5 从已有模型转换
由于从头预训练成本很高,另一条实用路线是把训练好的 Transformer 转换为高效架构:GQA → MLA(TransMLA,利用第 6.5 节的包含关系)、MLA → MLA + DSA(GLM-5 只用约 20B tokens)、全注意力 → 线性混合(用原注意力层初始化线性层,再经蒸馏与长上下文继续训练)。这类方法的共同点是先对齐新旧模块的输出(注意力蒸馏、逐层 MSE 或 KL),再端到端微调。
12 数值稳定性与训练技术
长上下文同时放大了两类数值问题:logit 尺度(\(N\) 越大,越需要更大的 logit 间隔,式 3.4)与低精度误差(FP8/FP4 的 cache、索引器和 kernel)。开源模型常用的技巧如下。
QK-Norm. 对 query 和 key 分别做 RMSNorm 再求内积:\(\ell_{t,s}=\operatorname{RMSNorm}(\mathbf{q}_t)^\top\operatorname{RMSNorm}(\mathbf{k}_s)/\sqrt{d_h}\),把 logit 限制在 \(|\ell|\le\sqrt{d_h}\,\|\mathbf{g}_q\odot\mathbf{g}_k\|_\infty\) 量级(\(\mathbf{g}\) 为 RMSNorm 的增益),防止 logit 增长失控。Qwen3、Gemma 3 等使用 QK-Norm;DeepSeek-V4 对 query 与KV 条目 \(\mathbf{e}_u\) 做 RMSNorm 是同一思想。MLA 的 key 由缓存的潜变量生成,直接加 QK-Norm 会破坏权重吸收,因此 MLA 模型通常采用下面的 QK-Clip。
QK-Clip(Kimi K2 的 MuonClip). 每次参数更新后,检查每个头在当前批次上的最大 logit \(\ell^{\max}_h\)。若超过阈值 \(\tau\)(K2 中 \(\tau=100\)),就把该头的 query/key 投影按比例缩小:
对 MLA,只缩放每个头独有的部分(\(\mathbf{W}^{UQ}_h,\mathbf{W}^{UK}_h\) 各乘 \(\sqrt{\eta_h}\),\(\mathbf{W}^{QR}_h\) 乘 \(\eta_h\)),所有头共享的 \(\mathbf{W}^{KR}\) 不动。它不改变前向计算形式,只在 logit 失控的头上生效。GLM-5 的 Muon Split(第 6.5 节)从优化器侧达到了类似效果。
Logit soft-capping(Gemma 2). \(\ell\mapsto c\tanh(\ell/c)\)(注意力中 \(c=50\)),把 logit 平滑地限制在 \((-c,c)\)。它与 FlashAttention 的融合不如 QK-Norm 方便,Gemma 3 改用了 QK-Norm。
Attention sink 与输出门. 见式 (7.3) 与式 (11.3)。它们让头可以“不输出”,从根源上消除首 token 处的权重堆积和 massive activation,对 FP8 训练与长度外推都有帮助。
线性层的 L2 归一化与门的取值范围. 对 Delta 规则,\(\|\mathbf{k}_t\|=1\) 且 \(\beta_t\in(0,1)\) 保证转移矩阵 \(\mathbf{I}-\beta_t\mathbf{k}_t\mathbf{k}_t^\top\) 的特征值落在 \([0,1]\),再乘以 \(\alpha_t\in(0,1]\) 后状态范数不会增长:\(\|\mathbf{S}_t\|_2\le\|\mathbf{S}_{t-1}\|_2+\beta_t\|\mathbf{v}_t\|\)。若允许 \(\beta_t\in(0,2)\),转移矩阵出现负特征值,可以增强状态追踪(如奇偶性)能力,但需要更小心的数值处理。
低精度索引与 cache. DeepSeek-V3.2 在 FP8 量化前对索引器 q/k 做 Hadamard 旋转 \(\mathbf{x}\mapsto\mathbf{H}\mathbf{x}\)(\(\mathbf{H}\) 为正交 Hadamard 矩阵),由于 \((\mathbf{H}\mathbf{q})^\top(\mathbf{H}\mathbf{k})=\mathbf{q}^\top\mathbf{k}\),内积不变,但离群通道的能量被均匀分散,量化误差显著降低。DeepSeek-V4 进一步把索引器 QK 计算降到 FP4,并对 KV 条目的 RoPE 维度保留 BF16、其余维度用 FP8。
确定性选择. 稀疏注意力的 top-k 在 RL 中必须确定(第 8.6 节),否则训练与推理的“策略”不一致,等价于引入了额外的 off-policy 噪声。
13 长上下文训练配方
几乎所有开源模型都采用“短上下文预训练 → 分阶段扩展长度 → 长上下文后训练”的配方,原因有三:长序列训练按式 (3.2) 平方增长;高质量长文档稀少;短上下文能力需要大量 token 才能学好,没必要在长序列上学。
| 模型 | 预训练长度 | 扩展方式 | 目标长度 |
|---|---|---|---|
| Llama 3.1 | 8K | 6 个阶段逐步扩展,约 800B tokens;RoPE base \(5\times10^5\) + 式 (5.12) | 128K |
| Qwen2.5 / Qwen3 | 4K(主阶段) | 长上下文阶段 32K,RoPE base \(10^4\to10^6\)(ABF);推理时 YaRN(+DCA)到 128K | 128K |
| Qwen2.5-1M | 4K | 逐步扩展到 256K,base 增大到 \(10^7\);推理用 DCA + YaRN 外推 | 1M |
| DeepSeek-V3 | 4K | YaRN 两阶段:32K(1000 步)→ 128K(1000 步) | 128K |
| DeepSeek-V3.2 | 由 V3.1(128K)继续训练 | 稠密 warmup(索引器,约 2.1B tokens)→ 稀疏训练(约 944B tokens) | 128K |
| DeepSeek-V4 | 4K(稠密) | 前约 1T tokens 稠密;16K→64K 时引入稀疏(先短暂 warmup 索引器);最后扩展到 1M | 1M |
| Kimi K2 | 4K | 32K 退火阶段,再用 YaRN 扩展 | 128K |
| GLM-5 | — | mid-training:32K(1T)→ 128K(500B)→ 200K(50B);DSA 由 MLA 基座经 1000 步 warmup + 20B tokens 引入 | 200K |
| Gemma 3 | 32K | 预训练末期把全局层 RoPE 缩放 8 倍 | 128K |
| MiMo-V2-Flash | 32K | 扩展到 256K | 256K |
除了长度调度,以下做法在多份技术报告中反复出现:
- 文档内注意力掩码:把多篇文档拼接成长序列时,只允许每个 token 关注同一文档内的 token,避免无关文档之间的干扰;长上下文阶段再使用真正的长文档。
- 数据配比:长上下文阶段上采样书籍、代码仓库、论文等天然长文档,并混入一定比例的短数据,以保持短上下文能力;GLM-5 额外加入约 10M 个 issue–PR 对作为仓库级数据。
- 合成长程任务:多文档问答、长代码补全、检索与聚合类任务,用于训练模型实际使用远处的信息。
- 上下文并行:长于单卡容量的序列用 Ring Attention / Context Parallel(式 4.3)训练。
- 新注意力的“热启动”:稀疏/压缩/线性模块通常先在稠密模型上蒸馏对齐(式 8.15),再端到端训练,而不是从零开始。
- 推理期的上下文管理:在 agent 场景中,模型还需要配合上下文管理策略(例如 GLM-5 在 BrowseComp 上使用“保留最近 \(k\) 轮工具结果”和“超过阈值后全部丢弃”的组合),这是注意力之外的另一种长上下文手段。
14 对比
14.1 复杂度
下表给出单层的主导项(\(N\) 为上下文长度;常数和与 \(N\) 无关的投影计算省略)。“读取”指 decode 每步需要从 HBM 读取的 KV 量。
| 方法 | Prefill 计算 | Decode 每步计算 | Decode 每步读取 | KV cache | 精确远程检索 |
|---|---|---|---|---|---|
| MHA | \(N^2Hd_h\) | \(NHd_h\) | \(NHd_h\) | \(NHd_h\) | ✔ |
| GQA | \(N^2Hd_h\) | \(NHd_h\) | \(NH_{kv}d_h\) | \(NH_{kv}d_h\) | ✔ |
| MLA | \(N^2H(d_h+d_R)\) | \(NH(2d_c+d_R)\) | \(N(d_c+d_R)\) | \(N(d_c+d_R)\) | ✔ |
| SWA | \(NwHd_h\) | \(wHd_h\) | \(wH_{kv}d_h\) | \(wH_{kv}d_h\) | ✘(窗口外) |
| MoBA / MSA | 索引 \(N^2d_I\) + 主 \(Nk_{\text{top}}BHd_h\) | 同左除以 \(N\) | \(Nd_I+k_{\text{top}}BH_{kv}d_h\) | \(N(H_{kv}d_h+d_I)\) | ✔(取决于选择) |
| NSA | \(N^2Hd_h/\delta+N(nl'+w)Hd_h\) | 同左除以 \(N\) | \(NH_{kv}d_h/\delta+(nl'+w)H_{kv}d_h\) | \(NH_{kv}d_h(1+1/\delta)\) | ✔(取决于选择) |
| DSA | 索引 \(N^2H_Id_I\) + 主 \(Nk_{\text{top}}H(d_h+d_R)\) | 索引 \(NH_Id_I\) + 主 \(k_{\text{top}}H(2d_c+d_R)\) | \(Nd_I+k_{\text{top}}(d_c+d_R)\) | \(N(d_c+d_R+d_I)\) | ✔(取决于选择) |
| CSA | 索引 \(N^2H_Id_I/m\) + 主 \(N(k_{\text{top}}+w)Hd_e\) | 同左除以 \(N\) | \(Nd_I/m+(k_{\text{top}}+w)d_e\) | \(N(d_e+d_I)/m\) | ✔(\(m\) 粒度) |
| HCA | \(N^2Hd_e/m'\) | \(NHd_e/m'\) | \(Nd_e/m'\) | \(Nd_e/m'\) | 部分(\(m'\) 粒度) |
| 线性 / GDN / KDA | \(NCHd_k+NHd_kd_v\) | \(Hd_kd_v\) | \(Hd_kd_v\) | \(Hd_kd_v\)(常数) | ✘(容量 \(O(d_k)\)) |
14.2 开源模型的注意力配置
| 模型 | 注意力 | KV 形式 | 位置编码 | 上下文 |
|---|---|---|---|---|
| Llama 3.1 405B | 全注意力 | GQA(128 q / 8 kv) | RoPE \(5\times10^5\) + Llama3 缩放 | 128K |
| Llama 4 Scout / Maverick | chunked : 全局 = 3 : 1 | GQA | 局部 RoPE,全局 NoPE + 温度 | 10M / 1M |
| Qwen3-235B-A22B | 全注意力 | GQA(64 q / 4 kv),QK-Norm | RoPE \(10^6\) + YaRN | 32K 原生 / 128K |
| Qwen3-Next / Qwen3.5 | GDN : Gated Attention = 3 : 1 | 线性状态 + GQA | 全注意力层部分 RoPE | 262K 原生,可扩展到约 1M |
| DeepSeek-V3 / R1 | 全注意力 | MLA(\(d_c=512,d_R=64\)) | 解耦 RoPE + YaRN | 128K |
| DeepSeek-V3.2 | DSA(\(k_{\text{top}}=2048\)) | MLA + FP8 索引器 key | 解耦 RoPE | 128K |
| DeepSeek-V4 Pro / Flash | CSA / HCA 交替 + 窗口 + sink | 共享 KV,\(m=4\)、\(m'=128\) | 部分 RoPE + 输出反向旋转 | 1M |
| Kimi K2 / K2.5 | 全注意力 | MLA,QK-Clip | 解耦 RoPE + YaRN | 128K–256K |
| Kimi Linear | KDA : MLA = 3 : 1 | 线性状态 + MLA | MLA 层 NoPE | 1M |
| GLM-5 | DSA(\(k_{\text{top}}=2048\)) | MLA-256 | 解耦 RoPE | 200K |
| MiniMax-01 / M1 | Lightning : softmax = 7 : 1 | 线性状态 + GQA | RoPE | 1M |
| MiniMax-M2 / M2.5 | 全注意力 | GQA | RoPE | 约 200K |
| MiniMax-M3 | MSA(块稀疏) | GQA + 单头索引 key | RoPE | 1M |
| Gemma 3 | SWA : 全局 = 5 : 1,\(w=1024\) | GQA,QK-Norm | 局部 \(10^4\) / 全局 \(10^6\) | 128K |
| gpt-oss-120b / 20b | SWA : 全局 = 1 : 1,\(w=128\) | GQA-8 + 可学习 sink | RoPE + YaRN | 128K |
| MiMo-V2-Flash | SWA : 全局 = 5 : 1,\(w=128\) | GQA + 可学习 sink | RoPE | 256K |
14.3 演进时间线
把第 2.4 节的四个维度与时间线放在一起,可以看到三次明显的转向:
- 2023–2024:从“能读多长”到“读得起多长”。 位置外推(PI → YaRN → ABF)先解决“看不懂”,GQA 与 MLA 再解决“存不下”。这一阶段可见集合仍是 \([t]\)。
- 2025:从固定模式到内容相关。 静态稀疏(SWA 交错)在 RULER 等检索任务上掉点明显,NSA/MoBA/DSA 让 \(\mathcal{J}_t\) 依赖内容,在 128K–200K 上近乎无损;线性模型从固定衰减(Lightning)走到 Delta 规则与通道门控(GDN、KDA),并以 3:1 混合进入旗舰模型。
- 2026:从“少读”到“少存”。 1M 上下文让“只减少读取量”的稀疏注意力不够用,DeepSeek-V4 用序列维压缩同时减少存储、索引与计算;MiniMax 则选择了在 GQA 上做最简单的块稀疏,以换取工程兼容性。
15 讨论与展望
分层记忆的趋同. 把最新的几种设计放在一起看:
NSA 用了前三项,DeepSeek-V4 用了前三项加 sink,Kimi Linear 与 Qwen3.5 用了第四项加全注意力,Gemma 3 与 gpt-oss 用了第一项加全注意力与 sink。各方法的差别越来越像是在同一个分层记忆框架中选择哪些层级、每个层级分配多少预算。一个自然的方向是让模型按层、按头、甚至按 token 自适应地分配这些预算。
选择器的训练. 目前 DSA/MSA 的索引器靠 KL 蒸馏训练,且与主模型梯度隔离,本质上是在模仿稠密注意力。它的上限由稠密注意力决定,也很难在训练长度之外学到更好的选择。可导的软选择、直接以语言模型损失训练选择器、在 RL 中稳定地更新选择器,都还是开放问题。
线性记忆的容量. 式 (10.5) 给出的 \(O(d_k)\) 上限是线性模型的根本限制。更大的状态(更多头、更大的 \(d_k\))、非线性状态(MLP 作为记忆,即测试时训练)、以及 Delta 规则的多步或高阶变体,都是在提高或更好地利用容量。如何在不破坏 chunkwise 并行的前提下突破这个上限,决定了线性模型能否在精确检索上追上 softmax。
软硬件协同. MLA 与 DSA 在带宽受限场景很高效,但对推理框架的改动大;MSA 选择 GQA 是为了复用现有栈;V4 把索引器降到 FP4。注意力的设计越来越受 kernel、精度格式与推理系统(分页、前缀缓存、投机解码、PD 分离)的约束。一种注意力能否被广泛采用,往往取决于它能否在主流推理框架中高效实现。
评估. needle-in-a-haystack 已基本饱和,RULER、LongBench v2、MRCR 等更难的基准,以及长时程的 agent 任务(SWE、BrowseComp、终端任务)更能区分不同方案。MiniMax 的经验说明,混合或稀疏架构的退化往往出现在多跳推理等公开基准覆盖不足的地方,需要专门构造评估。另外,长上下文能力与上下文管理策略(压缩、丢弃、摘要)高度耦合,二者需要一起评估。
多模态. 长视频与长音频把上下文推向更高的量级(Qwen3.5-Omni 支持 10 小时以上的音频输入,MiniMax-M3 的 1M 上下文也面向长视频),而视觉 token 的冗余度远高于文本,序列压缩(方向 F)和动态稀疏(方向 E)在多模态中可能更有优势。
16 参考文献
基础与系统 - Vaswani et al. Attention Is All You Need. NeurIPS 2017. - Dao et al. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS 2022;Dao. FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning. 2023;Shah et al. FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision. 2024. - Liu, Zaharia, Abbeel. Ring Attention with Blockwise Transformers for Near-Infinite Context. 2023. - Kwon et al. Efficient Memory Management for Large Language Model Serving with PagedAttention. SOSP 2023.
位置编码与外推 - Su et al. RoFormer: Enhanced Transformer with Rotary Position Embedding. 2021. - Chen et al. Extending Context Window of Large Language Models via Positional Interpolation. 2023. - Peng et al. YaRN: Efficient Context Window Extension of Large Language Models. 2023. - Xiong et al. Effective Long-Context Scaling of Foundation Models. 2023. - An et al. Training-Free Long-Context Scaling of Large Language Models (Dual Chunk Attention). 2024. - Nakanishi. Scalable-Softmax Is Superior for Attention. 2025. - Liu et al. Lost in the Middle: How Language Models Use Long Contexts. 2023.
KV 共享与压缩 - Shazeer. Fast Transformer Decoding: One Write-Head is All You Need (MQA). 2019. - Ainslie et al. GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. 2023. - DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model (2024a);DeepSeek-V3 Technical Report (2024b). - Meng et al. TransMLA: Multi-Head Latent Attention Is All You Need. 2025.
静态稀疏与 sink - Jiang et al. Mistral 7B. 2023. - Xiao et al. Efficient Streaming Language Models with Attention Sinks (StreamingLLM). 2023. - Sun et al. Massive Activations in Large Language Models. 2024. - Gemma Team. Gemma 2: Improving Open Language Models at a Practical Size (2024);Gemma 3 Technical Report (2025). - OpenAI. gpt-oss-120b & gpt-oss-20b Model Card. 2025. - Meta. The Llama 3 Herd of Models (2024);Llama 4 发布说明 (2025). - Xiaomi. MiMo-V2-Flash Technical Report. arXiv:2601.02780, 2026.
动态稀疏与序列压缩 - Lu et al. MoBA: Mixture of Block Attention for Long-Context LLMs. 2025. - Yuan et al. Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention. ACL 2025. - DeepSeek-AI. DeepSeek-V3.2: DeepSeek Sparse Attention. 2025. - DeepSeek-AI. DeepSeek-V4 Technical Report. 2026. - Lai et al. MiniMax Sparse Attention. arXiv:2606.13392, 2026. - Zhipu AI. GLM-5: From Vibe Coding to Agentic Engineering. arXiv:2602.15763, 2026.
线性注意力与混合架构 - Katharopoulos et al. Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention. ICML 2020. - Schlag, Irie, Schmidhuber. Linear Transformers Are Secretly Fast Weight Programmers. ICML 2021. - Sun et al. Retentive Network: A Successor to Transformer for Large Language Models (RetNet). 2023. - Yang et al. Gated Linear Attention Transformers with Hardware-Efficient Training (GLA). ICML 2024a. - Yang et al. Parallelizing Linear Transformers with the Delta Rule over Sequence Length. NeurIPS 2024b. - Dao & Gu. Transformers are SSMs: Generalized Models and Efficient Algorithms through Structured State Space Duality (Mamba-2). ICML 2024. - Yang, Kautz, Hatamizadeh. Gated Delta Networks: Improving Mamba2 with Delta Rule. ICLR 2025. - Kimi Team. Kimi Linear: An Expressive, Efficient Attention Architecture. arXiv:2510.26692, 2025. - MiniMax. MiniMax-01: Scaling Foundation Models with Lightning Attention. 2025;MiniMax-M1: Scaling Test-Time Compute Efficiently with Lightning Attention. 2025;Why Did MiniMax M2 End Up as a Full Attention Model? 2025. - Qwen Team. Qwen3 Technical Report (2025);Qwen2.5-1M Technical Report (2025);Qwen3-Next / Qwen3.5 发布说明 (2025–2026). - Qiu et al. Gated Attention for Large Language Models: Non-linearity, Sparsity, and Attention-Sink-Free. NeurIPS 2025. - Lieber et al. Jamba: A Hybrid Transformer-Mamba Language Model. 2024. - A Provable Expressiveness Hierarchy in Hybrid Linear-Full Attention. arXiv:2602.01763, 2026.
稳定性与优化 - Kimi Team. Kimi K2: Open Agentic Intelligence (MuonClip / QK-Clip). 2025.
博客笔记(本文的主要起点) - Huiming Song. DeepSeek V3 Multi-head Latent Attention (MLA);MHA 和 MLA 的 KV cache 比较;DeepSeek-V3.2 Lightning Indexer;DeepSeek-V4: 1MM Token Context;GLM-5: From Vibe Coding to Agentic Engineering;KDA - 从线性注意力到 Kimi Delta Attention.